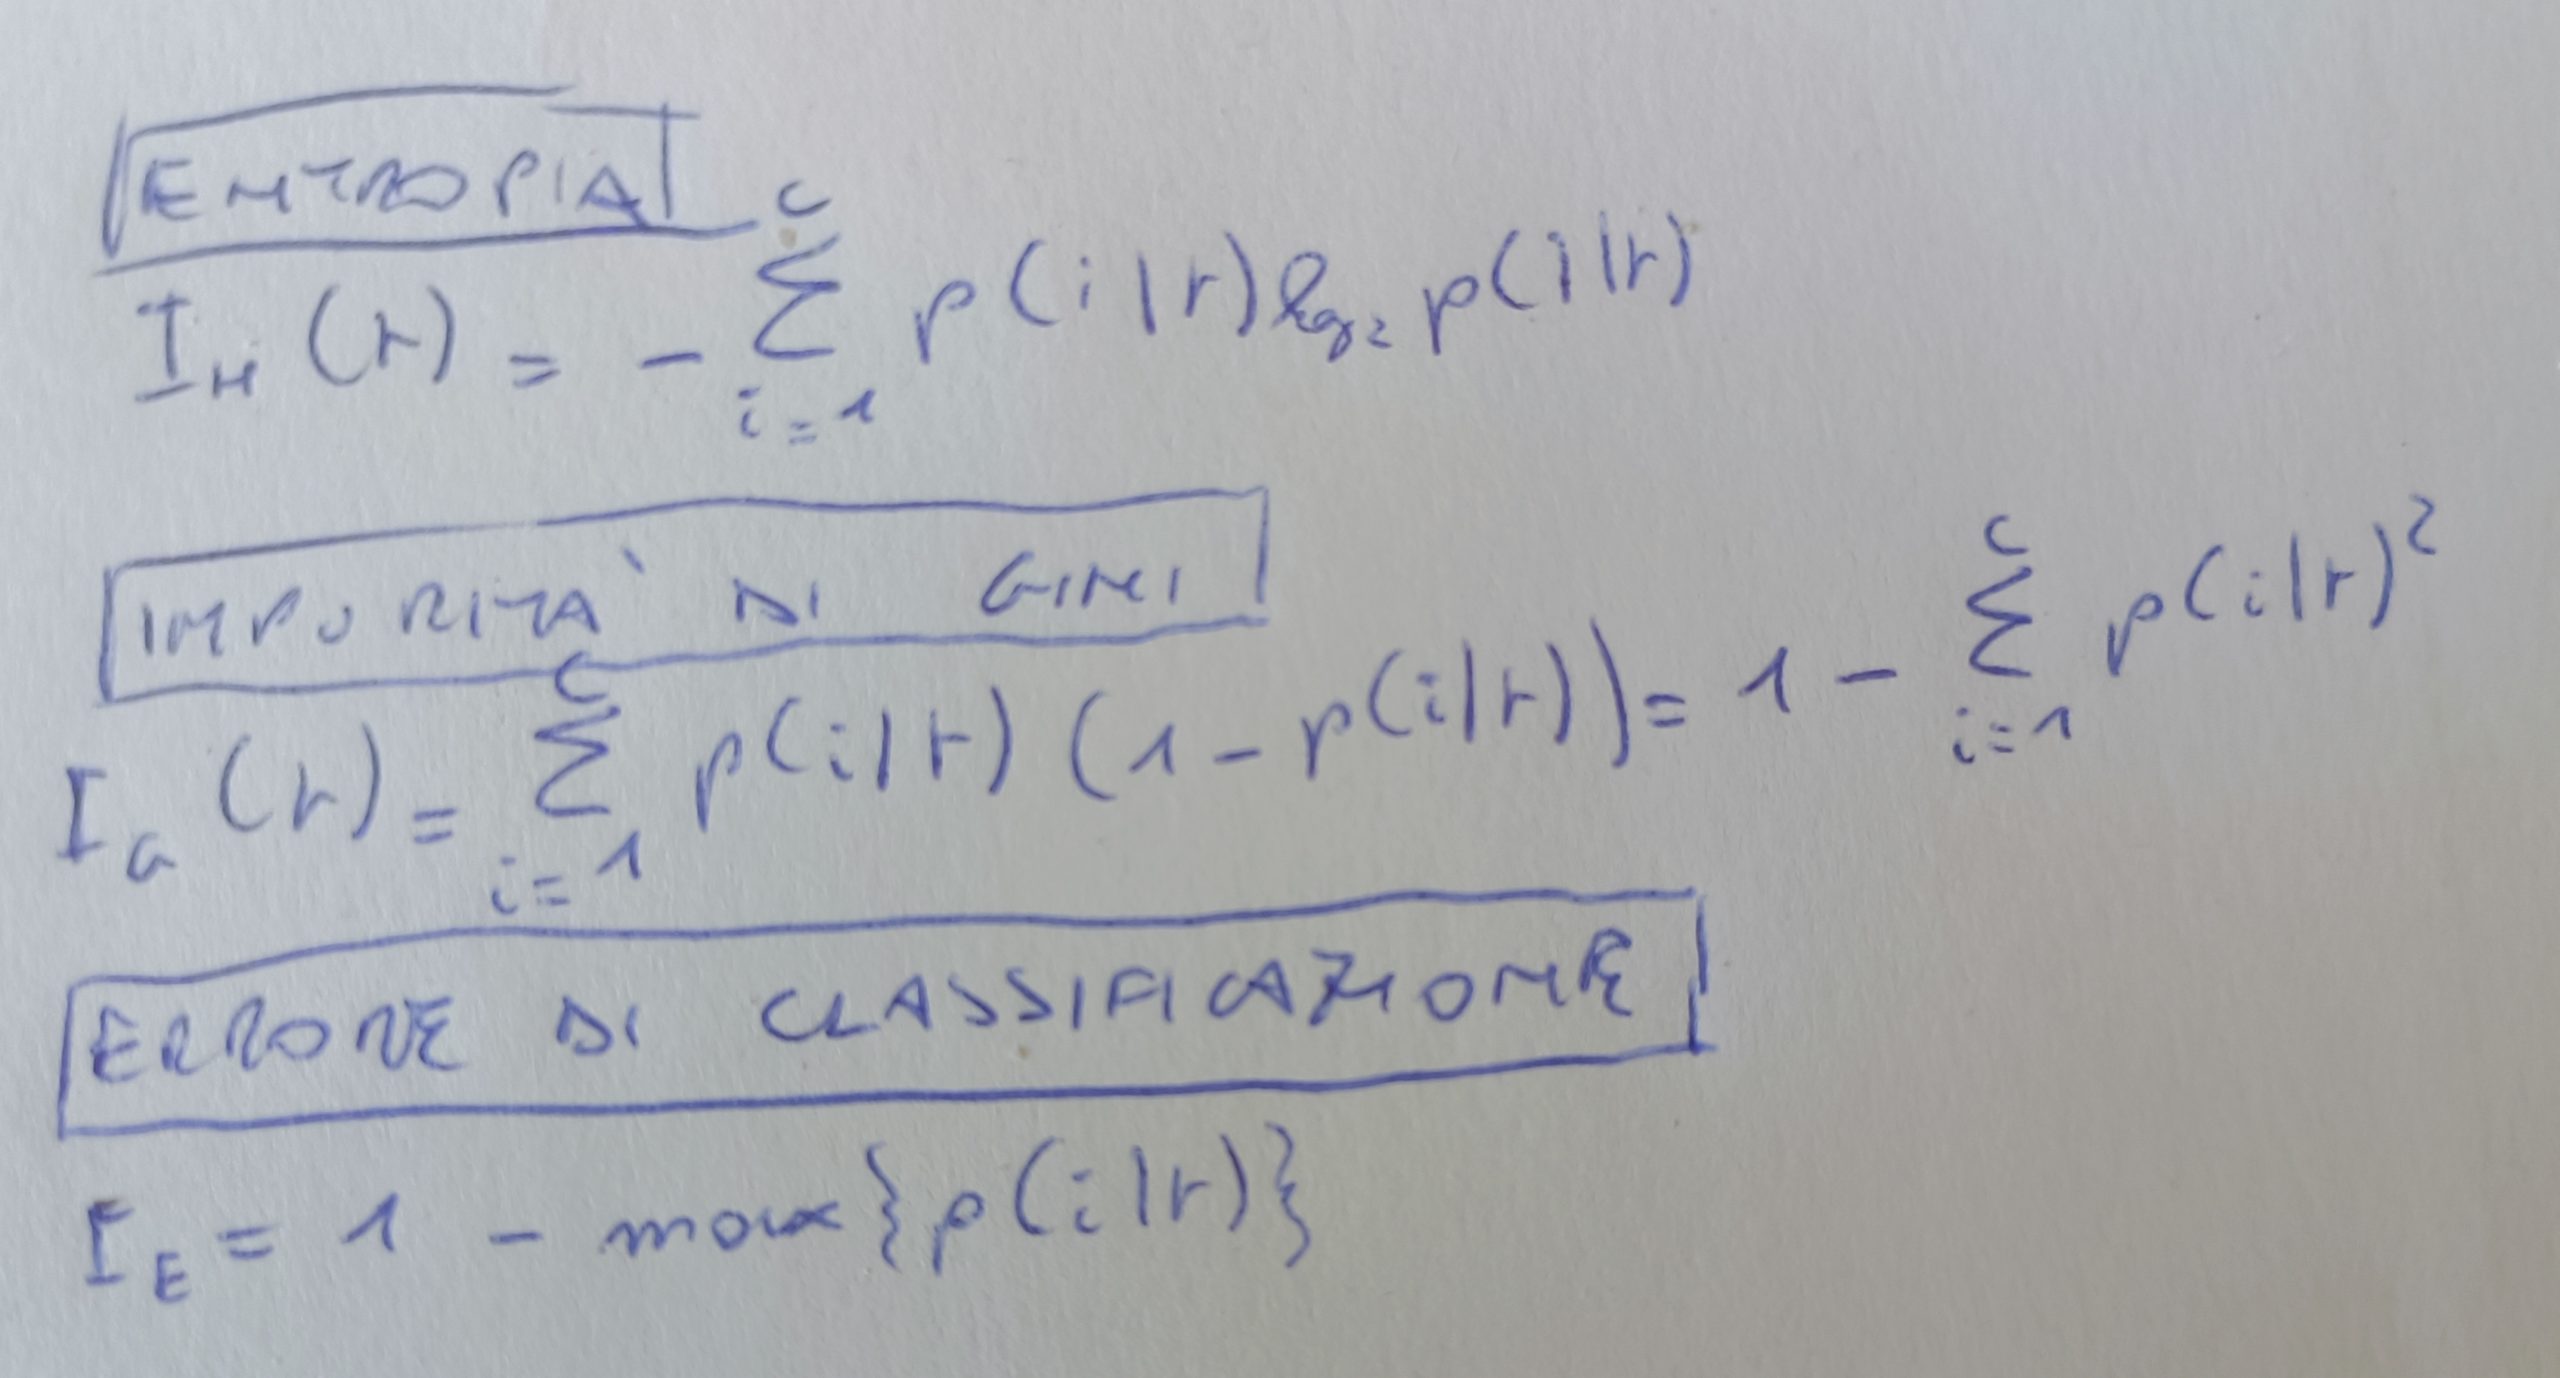
Confronto tra modelli di classificazione

Durante un progetto di Machine Learning è necessario valutare accuramente le performance del modello scelto per la predizione ed le probabilità di errore. In questo articolo valuteremo le performance dei principali modelli di predizione sul dataset Iris.

Prima di tutto preleviamo il dataset e esploriamo il campione dei dati attraverso il grafico delle distribuzioni delle caratteristiche sul target Species (pairplot)

df.head()

  SepalLengthCm  SepalWidthCm  PetalLengthCm  PetalWidthCm      Species
0            5.1           3.5            1.4           0.2  Iris-setosa
1            4.9           3.0            1.4           0.2  Iris-setosa
2            4.7           3.2            1.3           0.2  Iris-setosa
3            4.6           3.1            1.5           0.2  Iris-setosa
4            5.0           3.6            1.4           0.2  Iris-setosa

df.describe()

count     150.000000    150.000000     150.000000    150.000000
mean        5.843333      3.054000       3.758667      1.198667
std         0.828066      0.433594       1.764420      0.763161
min         4.300000      2.000000       1.000000      0.100000
25%         5.100000      2.800000       1.600000      0.300000
50%         5.800000      3.000000       4.350000      1.300000
75%         6.400000      3.300000       5.100000      1.800000
max         7.900000      4.400000       6.900000      2.500000

sns.pairplot(df,hue=’Species’)

distribuzione delle caratteristiche

Osservando le distribuzioni possiamo notare che la specie IrisSetosa è abbastanza distinta dalle altre due specie. Questo ci permetterà di utilizzare modelli che richiedono una distinzione netta tra le caratteristiche (es. perceptron).

Nell’ottica di studiare le performance per ciascun modello prendiamo in esame il dataset delle caratteristiche sepal length e sepal width ed il target Species. Suddividiamo il dataset in dati di training e di test con la funzione train test split.

X_train, X_test, y_train, y_test = train_test_split(X, y, random_state=40, test_size=0.3)

Per ogni modello utilizzato costruiamo codice per l’apprendimento, per la predizione e per la performance.

def chooseModel(model,xtr,ytr,xt,yt):
        model.fit(xtr, ytr)
        y_model = model.predict(xt)
        acc_model = accuracy_score(yt, y_model)
        return round(acc_model,5)

#LOGISTIC REGRESSION
accuracy=chooseModel(LogisticRegression(),X_train,y_train,X_test,y_test)
print('Logistic Regression accuracy: %.2f',accuracy)

#MAX MARGIN KERNEL LINEAR low C parameter--> high BIAS
accuracy=chooseModel(SVC(kernel='linear', C=1.0, random_state=0),X_train,y_train,X_test,y_test)
print('Max Margin kernel linear accuracy (low C): %.2f',accuracy)

#MAX MARGIN KERNEL LINEAR high C parameter--> high BIAS
accuracy=chooseModel(SVC(kernel='linear', C=10.0, random_state=0),X_train,y_train,X_test,y_test)
print('Max Margin kernel linear accuracy (high C): %.2f',accuracy)

#MAX MARGIN KERNEL GAUSSIAN RBF NON LINEAR, LOW GAMMA --> MORBID DECISION REGION
accuracy=chooseModel(SVC(kernel='rbf', gamma=0.10, C=10.0, random_state=0),X_train,y_train,X_test,y_test)
print('Max Margin kernel gaussian accuracy (low gamma): %.2f',accuracy)

#MAX MARGIN KERNEL GAUSSIAN RBF NON LINEAR, HIGH GAMMA --> RIGID DECISION REGION
accuracy=chooseModel(SVC(kernel='rbf', gamma=0.20, C=10.0, random_state=0),X_train,y_train,X_test,y_test)
print('Max Margin kernel gaussian accuracy (high gamma): %.2f',accuracy)


#NEIGHBOR CLASSIFIER, LOW NUMBER NEIGHBOR
accuracy=chooseModel(KNeighborsClassifier(n_neighbors=3),X_train,y_train,X_test,y_test)
print('neighbor classifier accuracy (low neighbor): %.2f',accuracy)


#NEIGHBOR CLASSIFIER, HIGH NUMBER NEIGHBOR
accuracy=chooseModel(KNeighborsClassifier(n_neighbors=10),X_train,y_train,X_test,y_test)
print('neighbor classifier accuracy (high neighbor): %.2f',accuracy)

#DECISION TREE
accuracy=chooseModel(DecisionTreeClassifier(),X_train,y_train,X_test,y_test)
print('decision tree accuracy: %.2f',accuracy)

#RANDOM FOREST
accuracy=chooseModel(RandomForestClassifier(),X_train,y_train,X_test,y_test)
print('random forest accuracy: %.2f',accuracy)

#GRADIENT BOOSTING
accuracy=chooseModel(GradientBoostingClassifier(),X_train,y_train,X_test,y_test)
print('gradient boosting accuracy: %.2f',accuracy)

Questo il risultato dell’accuratezza degli algoritmi (per ogni singolo classificatore vi rimandiamo alle rispettive pagine di questo blog)

Logistic Regression accuracy: %.2f 0.86667
Max Margin kernel linear accuracy (low C): %.2f 0.86667
Max Margin kernel linear accuracy (high C): %.2f 0.84444
Max Margin kernel gaussian accuracy (low gamma): %.2f 0.82222
Max Margin kernel gaussian accuracy (high gamma): %.2f 0.77778
neighbor classifier accuracy (low neighbor): %.2f 0.77778
neighbor classifier accuracy (high neighbor): %.2f 0.77778
decision tree accuracy: %.2f 0.75556
random forest accuracy: %.2f 0.77778
gradient boosting accuracy: %.2f 0.71111

aggiungiamo alla nostra funzione il codice

    print('******************')
    print(classification_report(y_model, y_test))
    print('******************')

ed otteniamo questi risultati:

                precision    recall  f1-score   support

    Iris-setosa       1.00      1.00      1.00        16
Iris-versicolor       0.86      0.75      0.80        16
 Iris-virginica       0.73      0.85      0.79        13

       accuracy                           0.87        45
      macro avg       0.86      0.87      0.86        45
   weighted avg       0.87      0.87      0.87        45

******************
Logistic Regression accuracy: %.2f 0.86667
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       1.00      1.00      1.00        16
Iris-versicolor       0.86      0.75      0.80        16
 Iris-virginica       0.73      0.85      0.79        13

       accuracy                           0.87        45
      macro avg       0.86      0.87      0.86        45
   weighted avg       0.87      0.87      0.87        45

******************
Max Margin kernel linear accuracy (low C): %.2f 0.86667
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       1.00      1.00      1.00        16
Iris-versicolor       0.79      0.73      0.76        15
 Iris-virginica       0.73      0.79      0.76        14

       accuracy                           0.84        45
      macro avg       0.84      0.84      0.84        45
   weighted avg       0.85      0.84      0.84        45

******************
Max Margin kernel linear accuracy (high C): %.2f 0.84444
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       1.00      1.00      1.00        16
Iris-versicolor       0.86      0.67      0.75        18
 Iris-virginica       0.60      0.82      0.69        11

       accuracy                           0.82        45
      macro avg       0.82      0.83      0.81        45
   weighted avg       0.85      0.82      0.82        45

******************
Max Margin kernel gaussian accuracy (low gamma): %.2f 0.82222
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       1.00      1.00      1.00        16
Iris-versicolor       0.86      0.60      0.71        20
 Iris-virginica       0.47      0.78      0.58         9

       accuracy                           0.78        45
      macro avg       0.77      0.79      0.76        45
   weighted avg       0.83      0.78      0.79        45

******************
Max Margin kernel gaussian accuracy (high gamma): %.2f 0.77778
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       1.00      0.94      0.97        17
Iris-versicolor       0.64      0.64      0.64        14
 Iris-virginica       0.67      0.71      0.69        14

       accuracy                           0.78        45
      macro avg       0.77      0.77      0.77        45
   weighted avg       0.79      0.78      0.78        45

******************
neighbor classifier accuracy (low neighbor): %.2f 0.77778
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       1.00      1.00      1.00        16
Iris-versicolor       0.86      0.60      0.71        20
 Iris-virginica       0.47      0.78      0.58         9

       accuracy                           0.78        45
      macro avg       0.77      0.79      0.76        45
   weighted avg       0.83      0.78      0.79        45

******************
neighbor classifier accuracy (high neighbor): %.2f 0.77778
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       1.00      0.94      0.97        17
Iris-versicolor       0.71      0.59      0.65        17
 Iris-virginica       0.53      0.73      0.62        11

       accuracy                           0.76        45
      macro avg       0.75      0.75      0.74        45
   weighted avg       0.78      0.76      0.76        45

******************
decision tree accuracy: %.2f 0.75556
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       1.00      0.94      0.97        17
Iris-versicolor       0.64      0.69      0.67        13
 Iris-virginica       0.73      0.73      0.73        15

       accuracy                           0.80        45
      macro avg       0.79      0.79      0.79        45
   weighted avg       0.81      0.80      0.80        45

******************
random forest accuracy: %.2f 0.8
------------------
------------------
******************
                 precision    recall  f1-score   support

    Iris-setosa       0.94      0.94      0.94        16
Iris-versicolor       0.64      0.53      0.58        17
 Iris-virginica       0.53      0.67      0.59        12

       accuracy                           0.71        45
      macro avg       0.70      0.71      0.70        45
   weighted avg       0.72      0.71      0.71        45

******************
gradient boosting accuracy: %.2f 0.71111
Esempi pratici e misura delle performance

Per analizzare le performance dell’algoritmo Perceptron prendiamo in esame un dataset molto studiato nell’ambito della machine learning: l’insieme delle caratteristiche della lunghezza e larghezza dei petali capaci di riconoscere una particolare famiglia Iris.

Per fare questo ci serviremo di importanti librerie di scikit-learn

anzitutto preleviamo il dataset

# load dataset
iris = datasets.load_iris()
X = iris.data[:, [2, 3]]
y = iris.target

definiamo tramite le funzioni di scikit-learn il training-set ed il testing-set e standardiziamo i campioni

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size = 0.4, random_state = 1, stratify = y)

sc = StandardScaler()
sc.fit(X_train) # calculate mu and sigma
X_train_std = sc.transform(X_train) # standardize
X_test_std = sc.transform(X_test)

utiliziamo il perceptron per risolvere il problema della classificazione e misuriamone le performance rappresentando i dati su un grafico. Parametriziamo il Perceptron con un numero di epoch pari a 50 ed un tasso di apprendimento pari a 0.2.

ppn = Perceptron(max_iter = 50, eta0 = 0.2, tol = 1e-3, random_state = 1)
ppn.fit(X_train_std, y_train)
y_pred = ppn.predict(X_test_std)
err =(y_test != y_pred).sum()
acc=(y_test == y_pred).sum() / len(y_test)

plt.plot(err)
plt.xlabel('wrong classification')
plt.show()

risultato:

y label count : [50 50 50]
y_train label count : [35 35 35]
y_test label count : [15 15 15]
wrong sample : 3
perceptron accurancy : 0.931

rappresentazione grafica dei dati.

dataset Iris

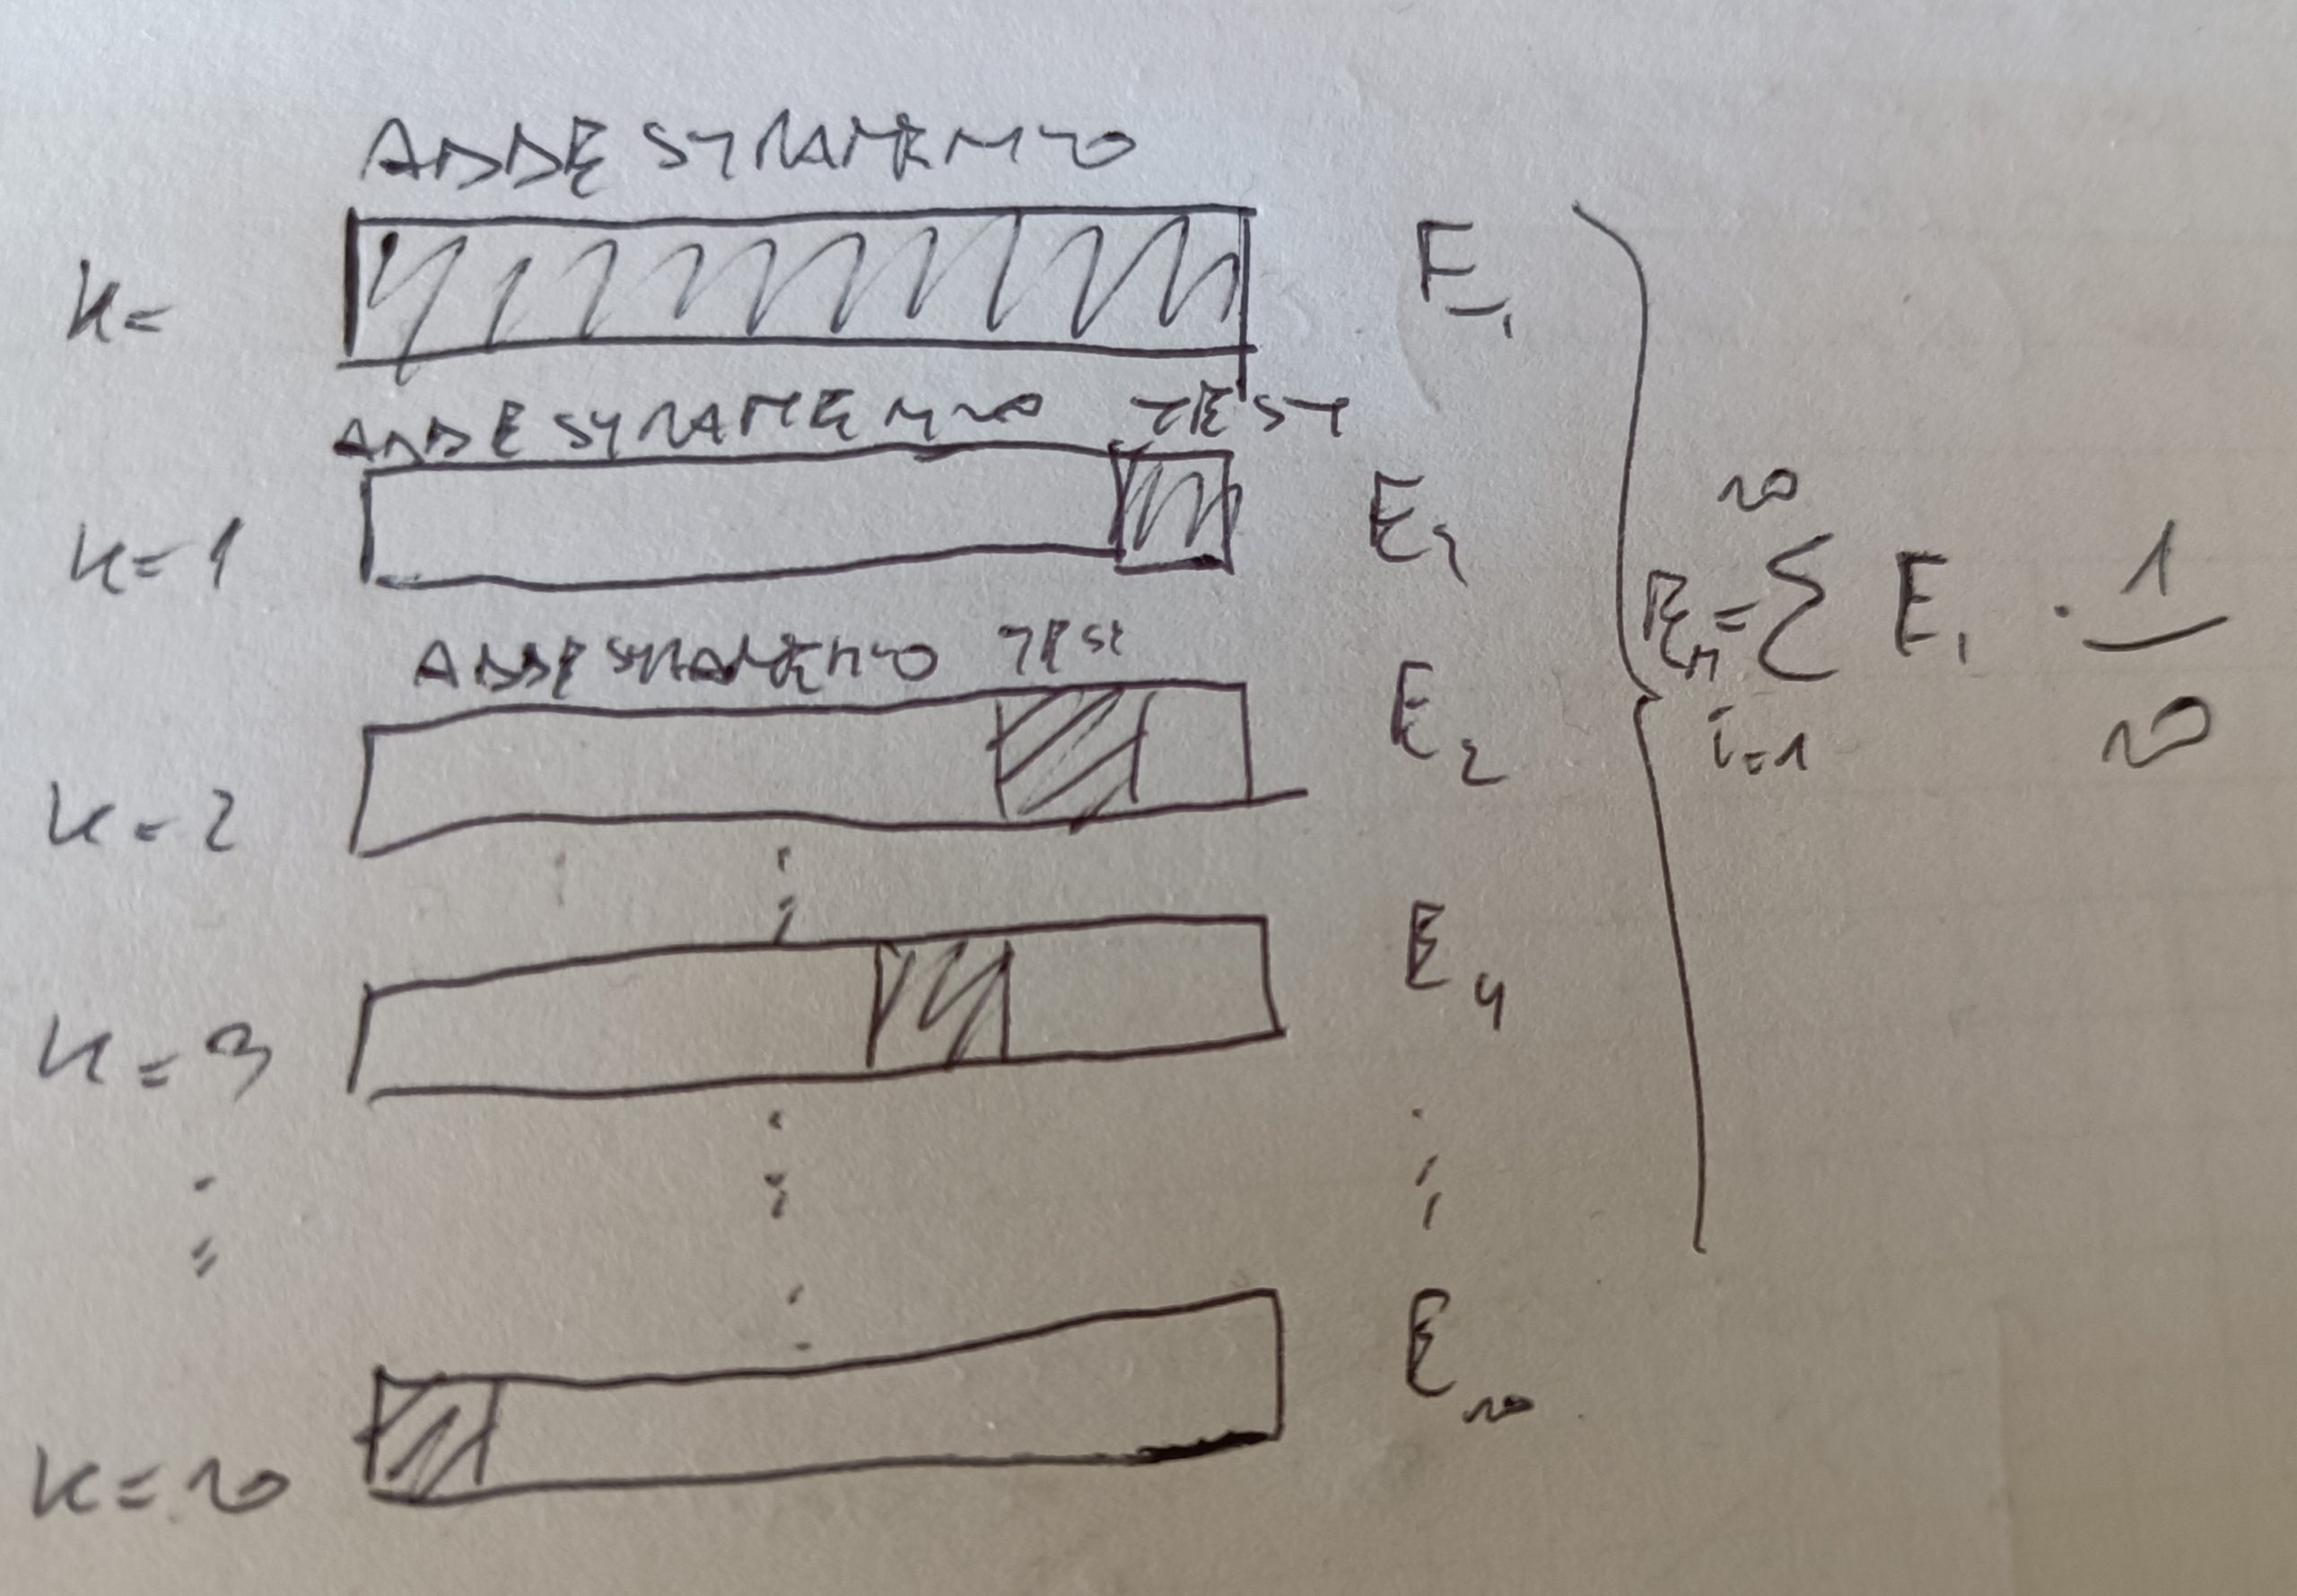
Una tecnica per misurare le performance di un modello è selezionare gli iperparametri di un algoritmo (ovvero i parametri che rendono l’algoritmo più efficiente rispetto la stima che si vuole avere) si chiama K-Fold.

La tecnica consiste nel suddividere il dataset in k parti senza reinserimento. K-1 viene usato per il test di addestramento, la restante parte viene usata per il test.

Per ogni fold viene calcolata la prestazione del modello ed infine viene calcolata la media delle prestazioni per tutti i fold. Vedi figura.

K-fold

#searching performance

#K-FOLD Stratified
skf = StratifiedKFold(n_splits=2)
skf.get_n_splits(X, y)

print(skf)

scores=[]


for train_index, test_index in skf.split(X, y):
        print("data train:", train_index, "data test:", test_index)
        X_train, X_test = X[train_index], X[test_index]
        y_train, y_test = y[train_index], y[test_index]
        pipe_lr.fit(X_train, y_train)
        score=pipe_lr.score(X_test,y_test)
        scores.append(score)
        print('test accurancy: %.3f ' %score)
print ('total accourancy: %.3f +/- %.3f ' %np.mean(scores), np.std(scores))


#CROSS VALIDATION SCORE
from sklearn.model_selection import cross_val_score
scores = cross_val_score(estimator=pipe_lr, X=X_train, y=y_train, cv=10, n_jobs=1)

print ('total accourancy: %.3f +/- %.3f ' %np.mean(scores), np.std(scores))

Il risultato

Class label : [0 1 2]
y label count : [50 50 50]
y_train label count : [35 35 35]
y_test label count : [15 15 15]
wrong sample : 3
perceptron accurancy : 0.93

Apprendimento ad albero decisionale

L’algoritmo ad apprendimento ad albero consiste nel trovare una serie di domande che consentono di suddividere il dataset dei dati sulla base della caratteristica che produce il massino guadagno informativo. Ad esempio, nel caso volessimo identificare se un campione di sangue è affetto da anemia perniciosa possiamo addestrare il modello ponendo domande sul volume medio dei globuli rossi (< 12?) e sulla quantità di vitamina B12 (<187?) (ovviamente non sono gli unici indicatori ed è un esempio solo illustrativo ma serve per avere un quadro della situazione). In base alle risposte possiamo etichettare i campioni nella classe corrispondente.

L’obiettivo è suddividere i campioni in modo da avere il massimo guadagno informativo IG.

Il guadagno informativo è descritto in questo modo:

IG(Dp,f)=I(Dp)-∑mj=1 Nj/Np I(Dj)

dove f è la carattersitica su cui si basa la suddivisione. Dp, Dj sono il datase del genitore e del j-esimo figlio. I è la misura di impurità. Np, Nj sono rispettivamente il numero di campioni dei genitori e del j-esimo figlio. Dall’equazione, minore è l’impurità dei figli e maggiore sarà il guadagno informativo.

Come individuiamo le impurità? generalmente vengono utilizzati 3 criteri di suddivisione o misure di impurità. Definendo p(i|t) come la proporzione dei campioni che appartengono al nodo t avremo:

Entropia Ih: è massima se tutti i campioni appartengono in maniera uniforme alle diverse classi. Considerando una classificazione binaria, sarà Ih= 1 se sono distruibuiti uniformemente per le due classi, quindi, p(i=1|t)=0,5. Sarà Ih=0 se tutti i campioni appartengono ad una o ad un’altra classe, quindi, p(i=1|t)=1 oppure P(i=0|t)=0. L’entropia cerca di massimizzare l’informazione reciproca all’interno di un albero.

Impurità di Gini Ig: cerca di minimizzare la probabilità di errori di classificazione. Maggiore è la mescolanza delle classi e maggiore sarà l’impurità di Gini.

Errore di classificazione Ie: utilizzato per la potatura di alberi decisionali. Se parto da un nodo padre e trovo un criterio di suddivisione che classifica tutti i campioni su una determinata classe, avrò diminuito le dimensioni dell’albero ma avrò aumentato l’errore di classificazione.

criteri di suddivisione dell’albero decisionale

Classificazione a massimo margine SVM

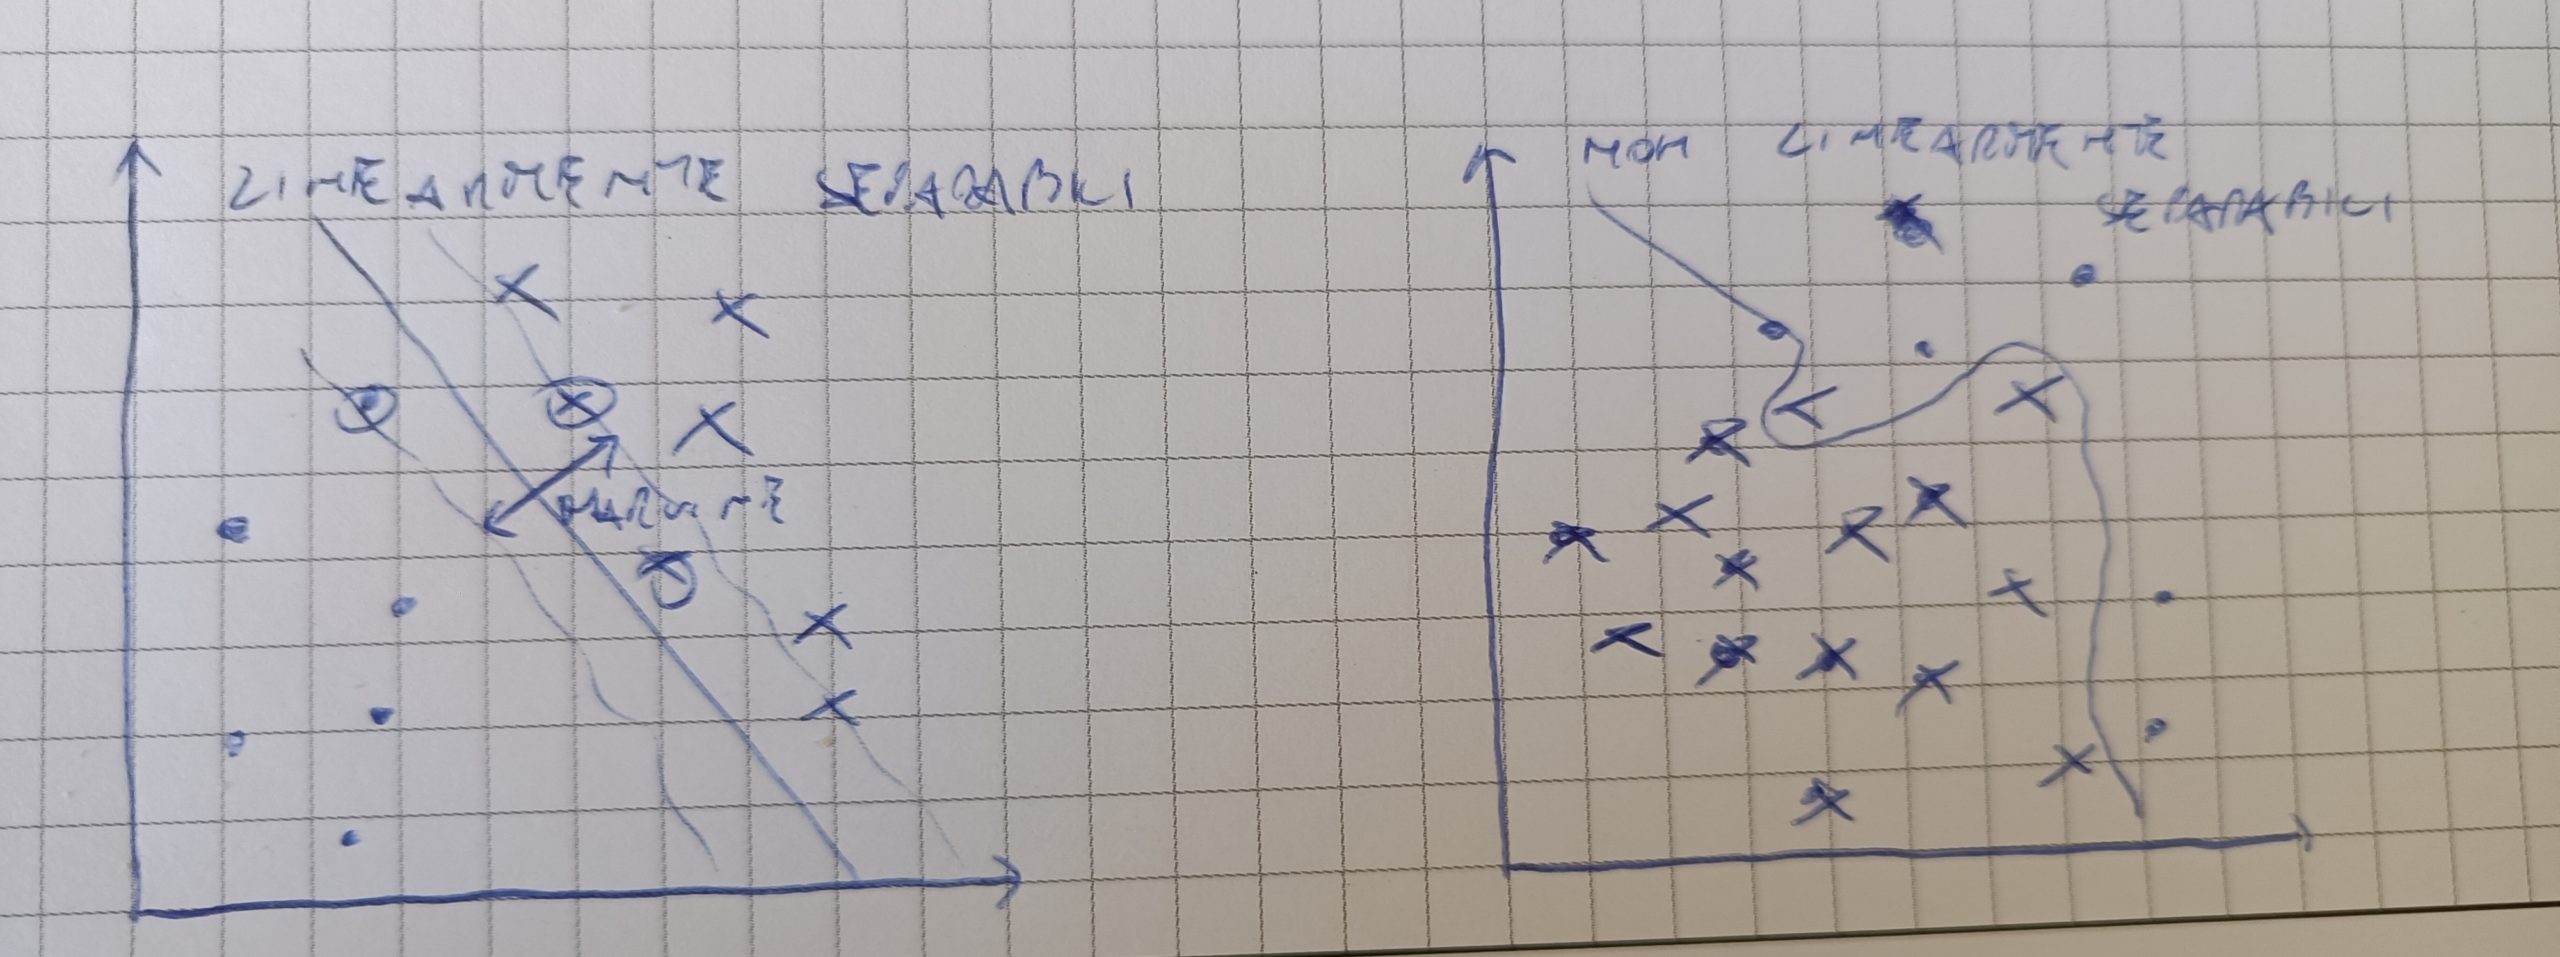
Un’estensione del perceptron è la macchina a vettori di supporto. Mentre per il perceptron il nostro obiettivo era minimizzare gli errori di apprendimento, con la macchina SVM l’obiettivo è massimizzare il margine definito come distanza tra l’iperpiano di separazione ed i campioni più vicini a questo iperpiano (vettori di supporto).

Massimizzando il margine possiamo effettuare nuove predizioni semplicemente usando un sottoinsieme dei dati di training che rappresentano i vettori di supporto.

Massimizzare il margine è facilmente comprensibile per la classificazione di dati che sono linearmente separabili. Cosa succede invece per campioni che non sono linearmente separabili?

esempio campioni linearmente separabili e non

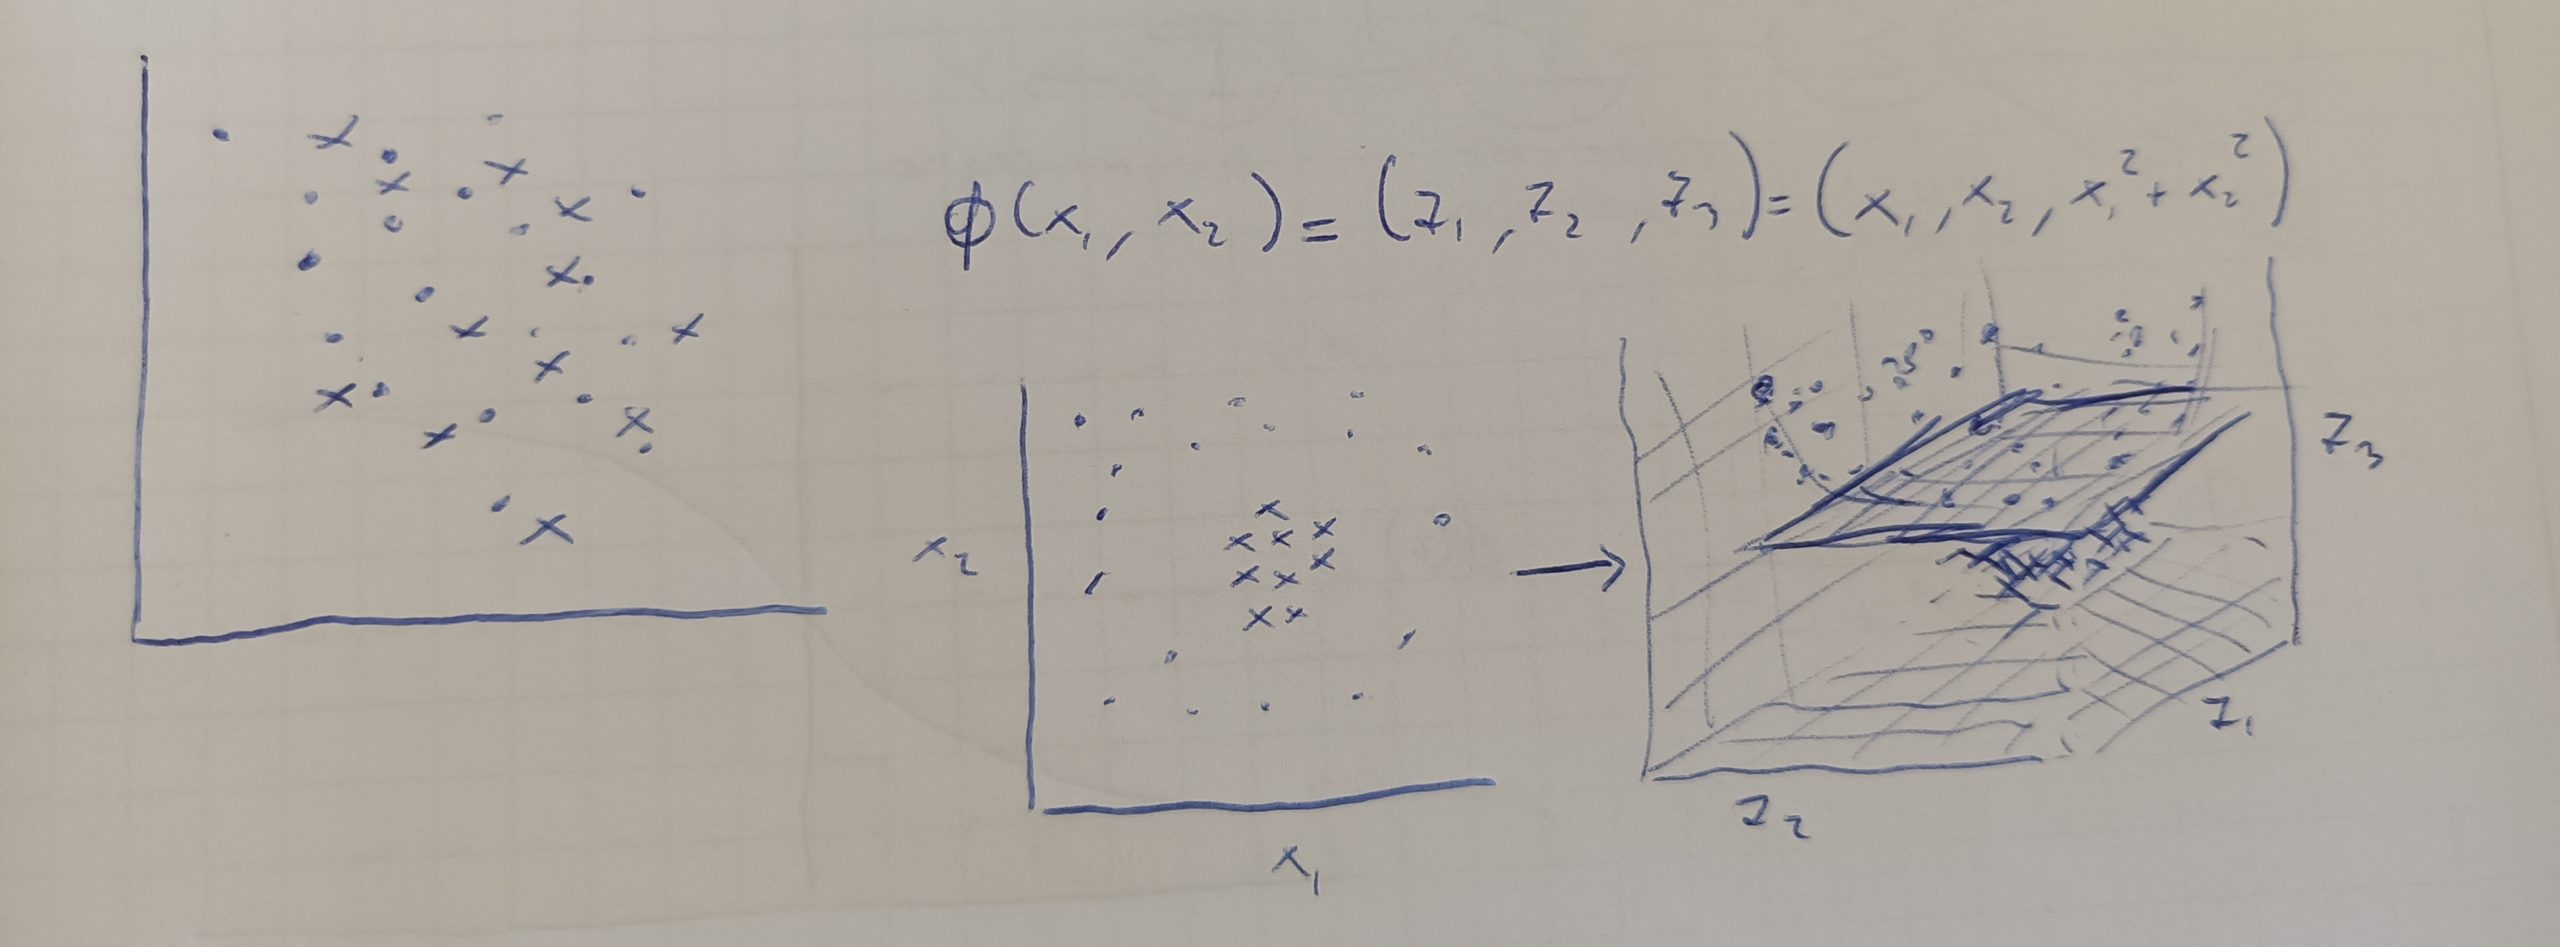
Per risolvere problemi di classificazione su campioni non lineari possiamo sfruttare l’algoritmo SVM in modo da kernizzarle su più dimensioni. L’obiettivo sarà di rappresentare i campioni non lineari con combinazioni tra i campioni in modo da aumentare la dimensionalità e cercare rappresentazioni non lineare ma con un marcato confine decisionale.

aumento dimensioni su campioni non lineari

Come si vede nell’immagine abbiamo aumentato la dimensionalità del modello semplicemente utilizzando la relazione X12 + X22 . Questo ha permesso di identificare un nuovo iperpiani di separazione dei campioni (seconda figura).

Regressione logista: modellazione della probabilità delle classi

La regressione logistica è un modello di classificazione (come il Perceptron o Adaline) che usa la probabilità per determinare l’appartenenza ad una piuttosto che ad un’altra classe.

Definiamo il rapporto probabilistico come il rapporto tra la probabilità di un evento positivo (p) e la probabilità di un evento negativo: p/(1-p). Rispettivamente p sarà la classe con etichetta y=1 e 1-p la classe con etichetta y=0.

La funzione logit è il logaritmo del rapporto delle probabilità logit=log(p/(1-p)). Possiamo dire che il logit(p(y=1|x)) = w0x0 + w1x1 +…+ wnxn –> può essere espressa come relazione lineare. Quello che vogliamo studiare è l’appartenenza di un determinato campione alla classe y=1. Quindi dobbiamo considerare l’inversa della funzone logit: sigmoid –> Ø(z)=1/(1+e¯z).

Intuitivamente l’algoritmo a regressione logistica calcola la probabilità che un campione appartenga ad una determinata classe. Si userà la funzione a passo unitario per determinare esattamente la classe di appartenenza.

Anche in questo caso sarà necessario definire una funzione di costo che ci permetterà di trovare i pesi sulla base dell’errore di classificazione.

Nel caso di Adaline la funzione di costo era la somma dei quadrati degli errori. Nel caso della regressione logistica la funzione di costo sarà una probabilità L(w)=P(y|x;w). Minimizzando la funzione di log-probabilità ed utilizzando l’algoritmo di discesa del gradiente riusciamo ad identificare i pesi per ogni iterazione. Questo algoritmo è possibile utilizzarlo anche per problemi multiclase.

A cosa serve la Business Intelligence?

In questo articolo parleremo degli strumenti di analisi delle informazioni per pura necessità di Business.

Come avevamo spiegato ormai diversi anni fa su questo articolo di questo blog, vi era in atto una trasformazione del web non più inteso come raccolta di documenti ma come pura raccolta di dati.

In tutto il decennio appena trascorso sono aumentati a dismisura gli applicativi che generano dati: cose, animali, piante e persone generano ogni giorno milioni di dati attraverso qualsiasi tipo applicativi di qualsiasi natura (IoT, Industria 4.0, social, web, forum, ecommerce, ERP…).

Ai tempi della scrittura di questo articolo avevo posto una domanda: 

politica di apertura o di chiusura delle informazioni aziendali (ovviamente non parliamo delle informazioni riservate dei dipendenti o coperte da GDPR)? la risposta l’avremmo ricevuta soltanto in futuro. Oggi possiamo certamente dire che le aziende, per cogliere maggiori opportunità di business, sono quasi obbligate a condividere tutte le informazioni con il pubblico. Il cliente, ad esempio, è abituato da tempo a leggere le recensioni che descrivono la qualità di servizio o del prodotto. Se un’azienda, che lancia un prodotto, non prevede la possibilità di acquisire recensioni allora potrebbe avere minori opportunità di business.

Il discorso non vale solo per l’apertura dei dati verso il grande pubblico (dipende molto dal tipo di business) ma, in generale, dalla condivisione verso uno o più partner esterni all’organizzazione; per cogliere, ad esempio, le opportunità del cloud le aziende devono accettare di esporre i propri dati presso i partner provider.

Quando si parla di condivisione dati si sottintendono logiche di interfaccia applicativa o integrazioni che ogni azienda deve governare ed implementare. Sono esplosi quindi sistemi applicativi di ETL (Extract/Transform/Load).

Oggi quindi, andando oltre, la domanda che le organizzazioni devono porsi sarebbe: 

con tutta questa mole di dati riesco a creare informazioni utili e, di conseguenza, valore per la mia organizzazione?

In questi anni sono nate terminologie come data scientist, BigData, DataLake, data integrator… che hanno come unico scopo la progettazione e lo sviluppo di applicativi per rispondere alla domanda sopra.

Esistono quindi persone e tecnologie che, seguendo una determinata strategia, riescono a rispondere tranquillamente alla domanda che abbiamo fatto sopra. Da una parte ci sono evidenti vantaggi di riduzione dei processi decisionali e dall’altra un utilizzo intelligente dei dati attraverso algoritmi che se usati bene offrono spunti per nuove opportunità di business.

Adaline: ottimizzazione con la normalizzazione del dataset

Prendendo spunto dal paragrafo precedente per ottimizzare l’algoritmo di Adaline in modo che la funzione costo venga minimizzata in maniera più veloce allora è possibile standardizzare l’intero dataset con la normalizzazione delle caratteristiche.

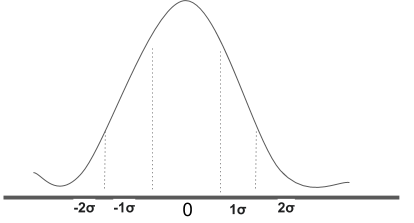
In che modo possiamo normalizzare? usando la distribuzione normale standard. la distribuzione normale standard prevede

distribuzione normale standard

Per normalizzare il dataset basta prendere ogni caratteristica, sottrarla per la media della distribuzione normale μ e dividere tutto per la deviazione standard σ

Ad esempio, per standardizzare la caratteristica j-esima è necessario prima sottrarre la media μj poi dividere per σj .

x‘j = (xj – μj)/σj

Addestriamo ora lo stesso algoritmo Adaline utilizzato nel paragrafo precedente con il dataset normalizzato. La libreria numPy ha già funzioni per calcolare la deviazione standard e la media.

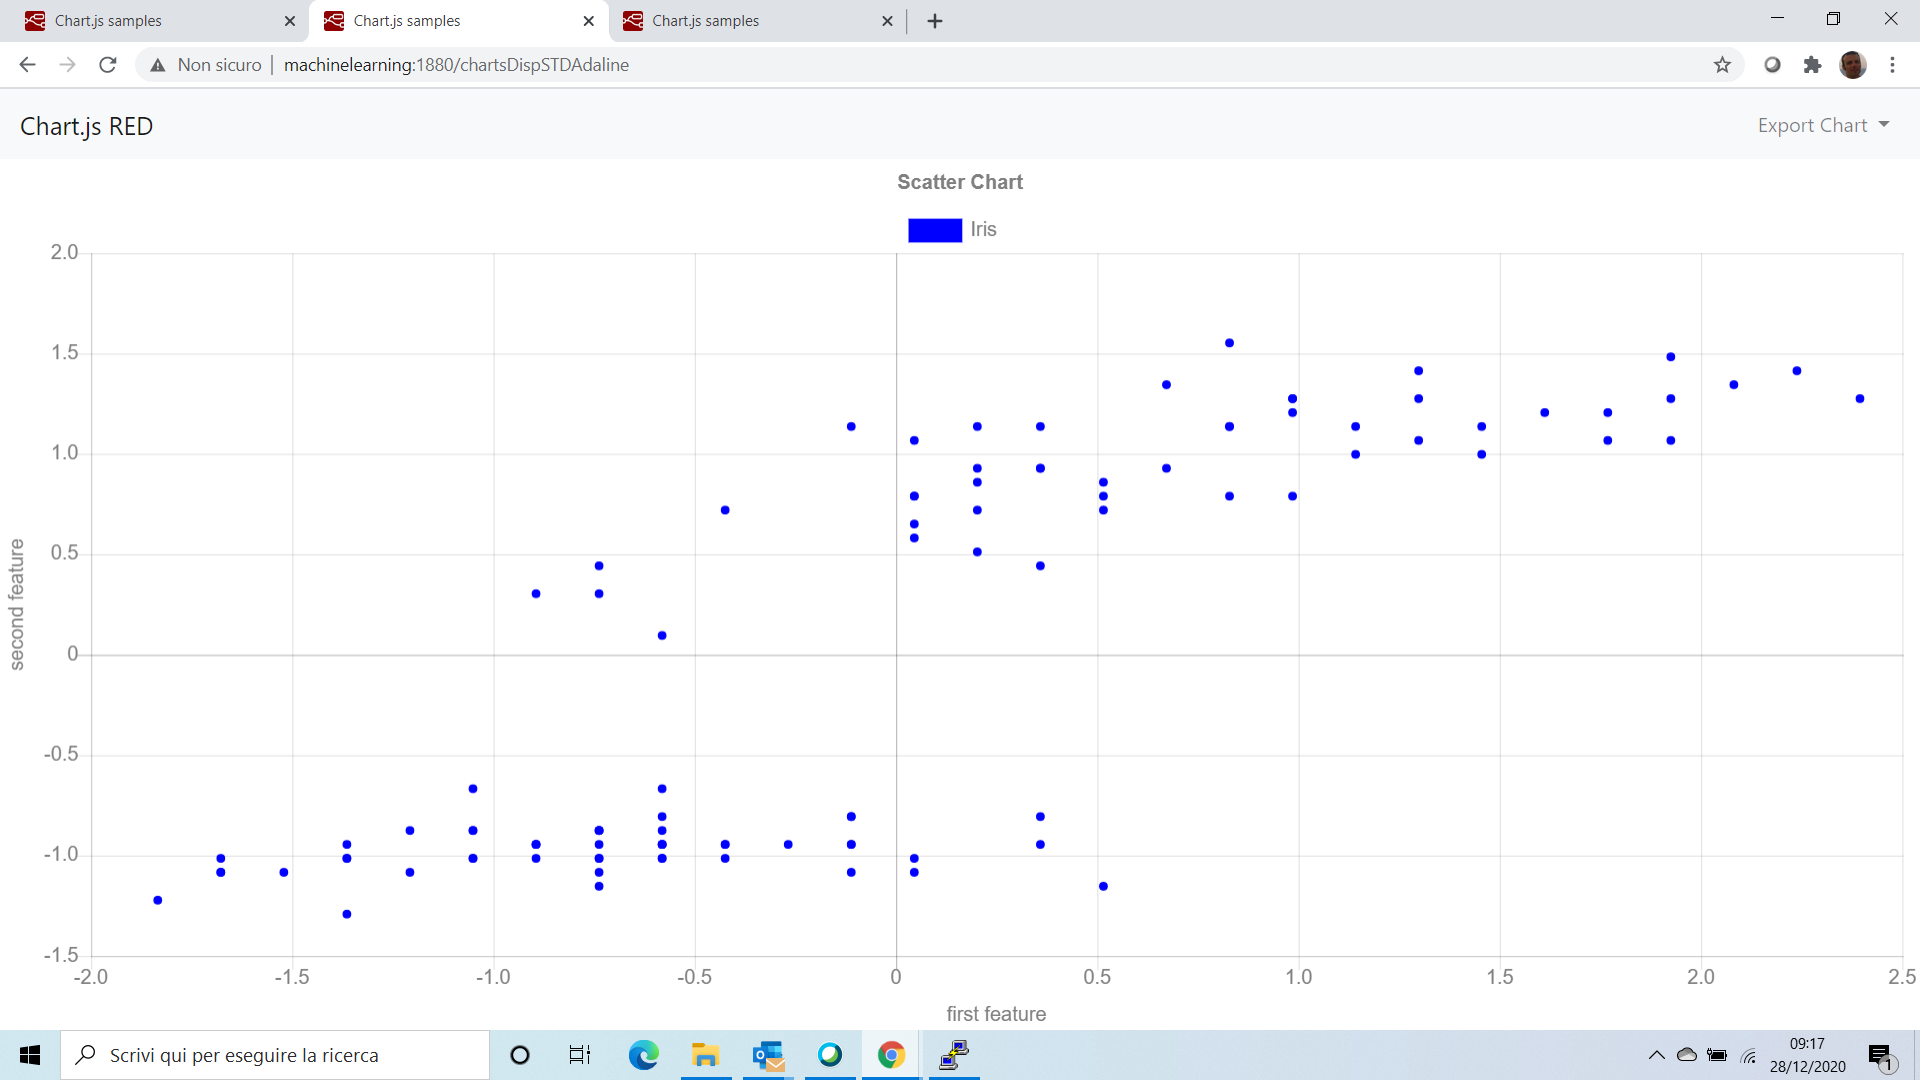
Anzitutto vediamo nel grafico i valori normalizzati,

dataset normalizzato

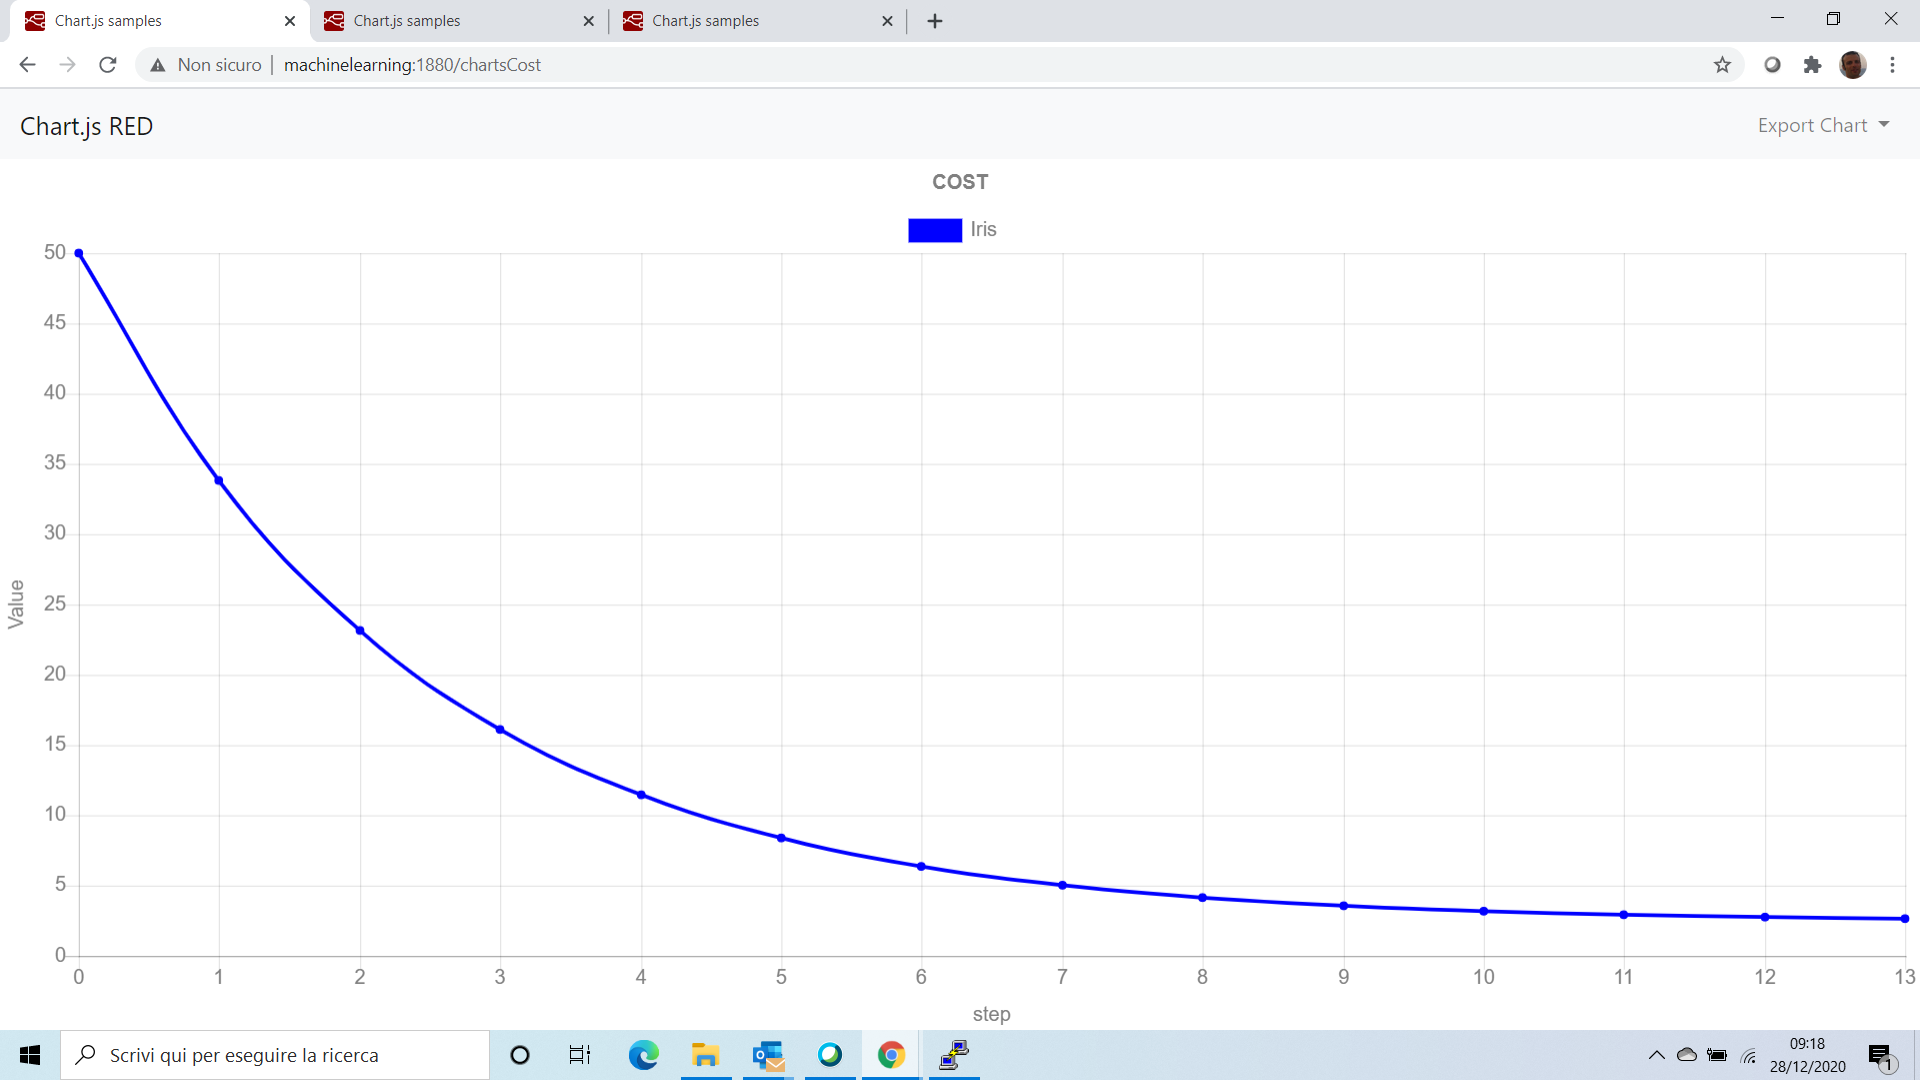
Addestriamo l’algoritmo con questi dati, dopo di che, osserviamo il grafico dei costi

pn = Adaline(0.01, 15)
pn.fit(X_std, y)

funzione dei costi

Il grafico mostra chiaramente la convergenza della funzione dei costi a fronte di un dataset normalizzato.

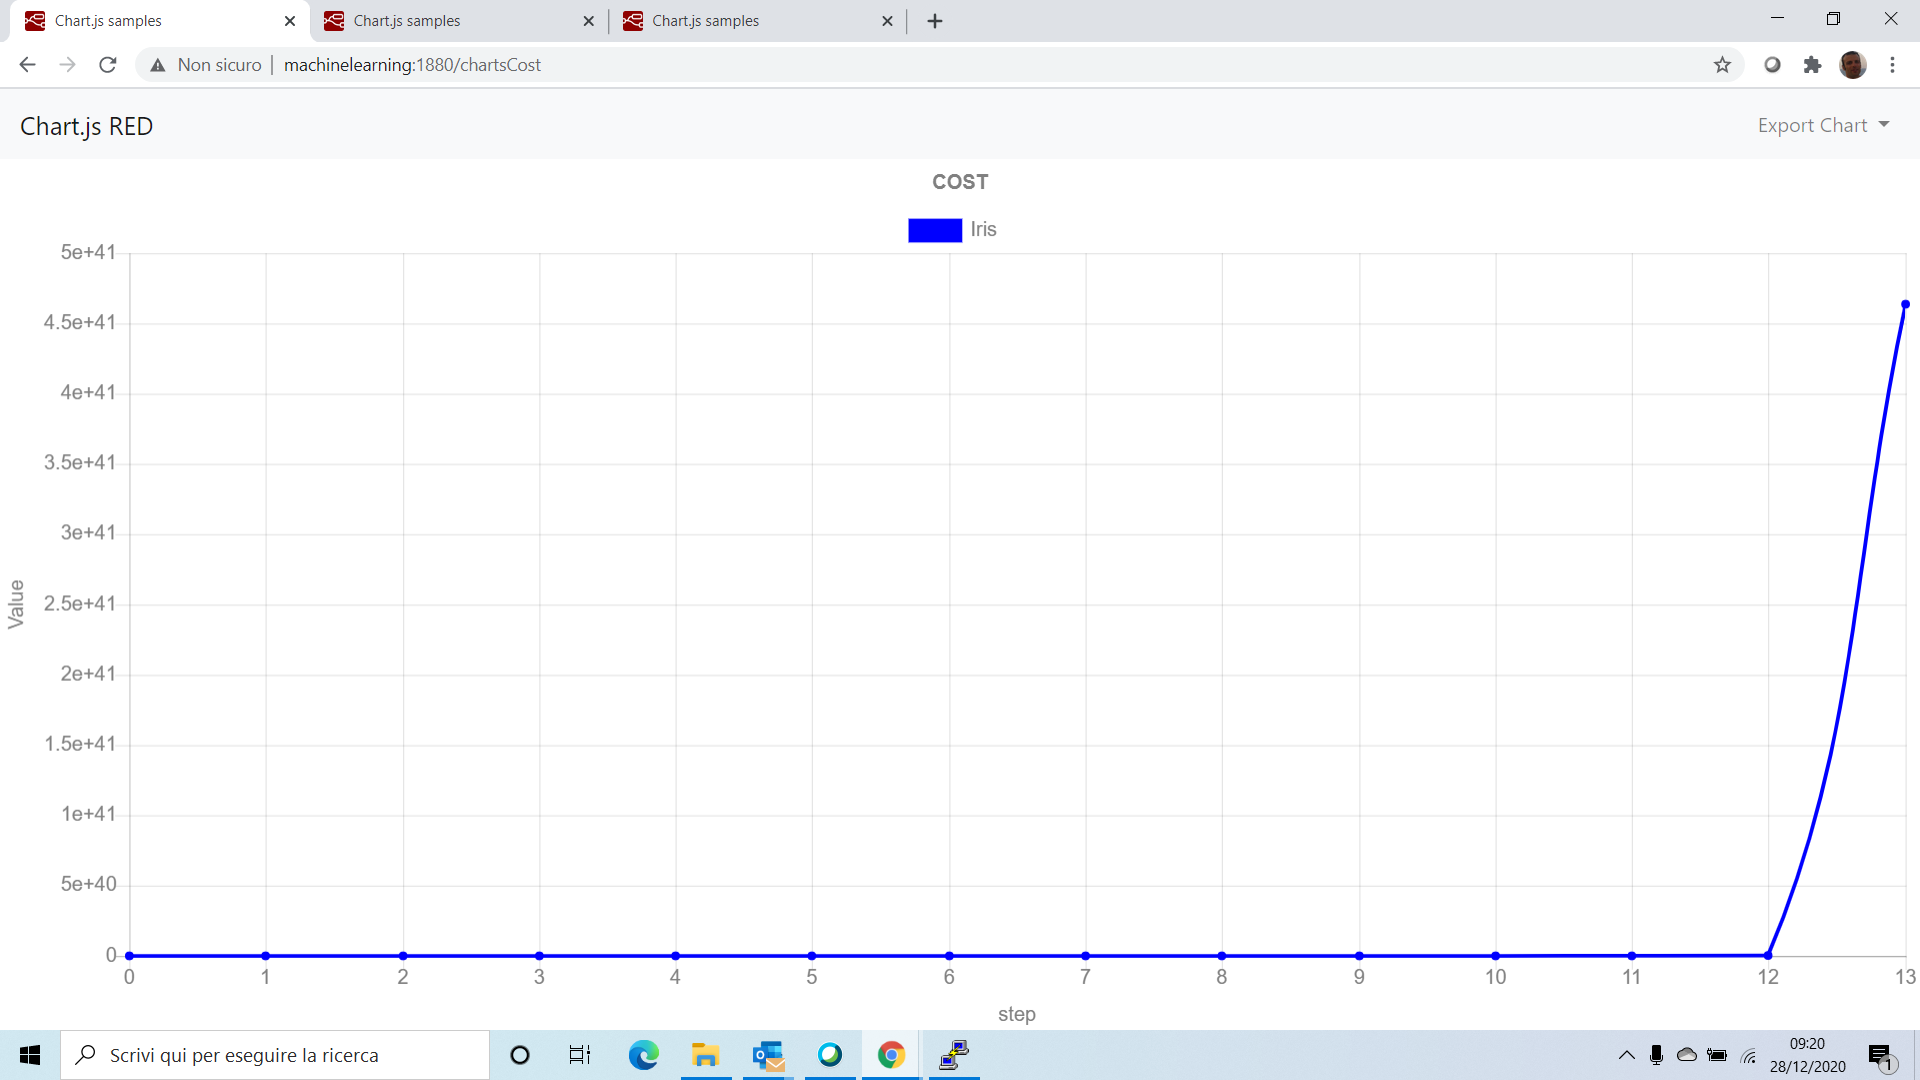
Giusto per fare un confronto mostriamo lo stesso grafico dei costi addestrando l’algoritmo con il dataset non normalizzato.

funzione di costo con dataset non normalizzato

Come volevasi dimostrare, la funzione di costo viene nettamente ottimizzata utilizzando il dataset normalizzato.

Adaline: MachineLearning con supervisione, algoritmo adattivo lineare

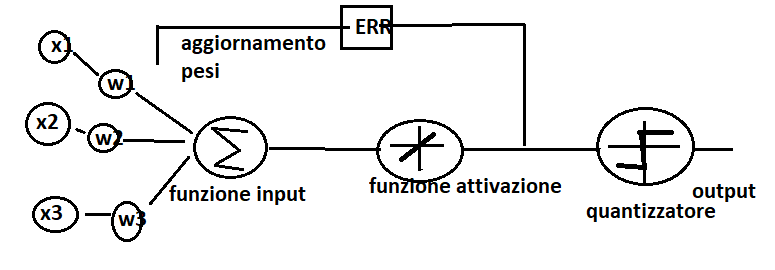
L’algoritmo Adaline (ADaptive LInear NEuron) è un algoritmo di convergenza dell’apprendimento. Ciò vuol dire che i pesi non si aggiornano ad ogni epoch sulla base di una funzione di attivazione binaria (come nel caso del Perceptron), ma si aggiornano sulla base di una funzione di attivazione lineare.

Come vediamo nel grafico sopra, la differenza con l’algoritmo Perceptron è che i pesi si aggiornano attraverso una funzione lineare ad ogni epoch. Questo consente di minimizzare la funzione di costo.

La funzione di costo è la funzione J che apprende i pesi in termini di somma dei quadrati degli errori (Sum Squared Errors – SSE) fra il risultato calcolato e la vera etichetta della classe.

J(w) = 1/2 Σi (y(i) – Φ (z(i)))2

Quali sono i vantaggi di questa funzione? Questa funzione di costo è differenziabile ed è convessa. Questo ci consente di utilizzare un algoritmo di discesa del gradiente per trovare i pesi che minimizzano la funzione di costo.

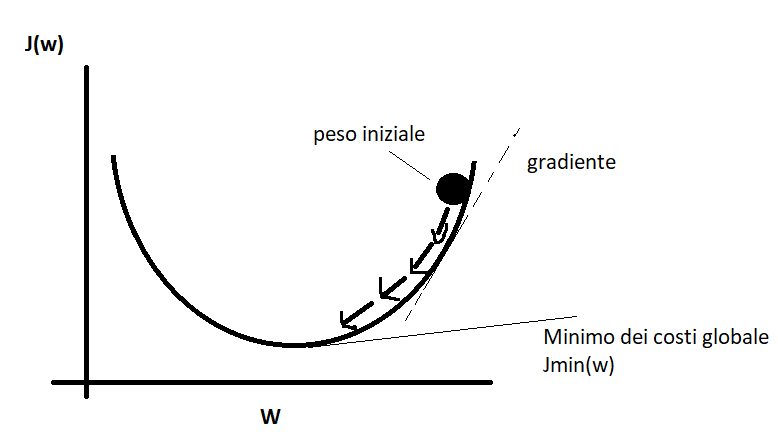
Come si può vedere nel grafico sopra, i pesi si aggiornano in base alla funzione di costo descritto in precedenza. A partire quindi da un peso iniziale (w), i pesi si aggiorneranno fino a raggiungere il minimo dei costi globale ed allontanandoci quindi dal gradJ(w)

Il cambiamento del peso è definito in questo modo:

Δ(w)= -η gradJ(w)

Per calcolare il gradiente è necessario fare la derivata parziale della funzione J ad ogni peso wi. Il vantaggio dell’algoritmo è che i pesi vengono aggiornati simultaneamente a differenza del Perceptron che venivano aggiornati ad ogni iterazione.

Perceptron: MachineLearning con supervisione e funzione di attivazione

In questo paragrafo spiegheremo come utilizzare l’algoritmo perceptron implementato con Python a partire da un dataset di dati utilizzati principalmente per la studio del machineLearning: l’insieme di caratteristiche che definiscono delle tipologie di fiori Iris.

Iniziamo con l’implementazione del perceptron.py (l’algoritmo spiegato nell’articolo precedente) definendo i metodi fit (per l’apprendimento) e prediction (per la previsione dei nuovi dati)

il dataset iris è una serie di dati, solitamente a matrice, che come righe si ha il numero dei campioni e sulle colonne le caratteristiche per ogni campione.

esempio:
0 5.1 3.5 1.4 0.2 Iris-setosa
1 4.9 3.0 1.4 0.2 Iris-setosa
2 4.7 3.2 1.3 0.2 Iris-setosa
3 4.6 3.1 1.5 0.2 Iris-setosa
4 5.0 3.6 1.4 0.2 Iris-setosa
.. … … … … …
145 6.7 3.0 5.2 2.3 Iris-virginica
146 6.3 2.5 5.0 1.9 Iris-virginica
147 6.5 3.0 5.2 2.0 Iris-virginica
148 6.2 3.4 5.4 2.3 Iris-virginica
149 5.9 3.0 5.1 1.8 Iris-virginica

Il problema che vogliamo risolvere è: dato un campione di dati con determinate caratteristiche, a quale classe corrisponde? Iris-setosa oppure Iris-virginica?

la prima cosa da fare è inputare all’algoritmo perceptron il set di dati.

from perceptron import Perceptron

pn = Perceptron(0.1, 10)
pn.fit(X, y)

print(“dataset”,df)
print(“target”,y)
print(“training”,X)

print(“errors”,pn.errors)
print(“weight”,pn.weight)

Una volta importato l’algoritmo perceptron utilizziamo la funzione di apprendimento “fit” imputando il set di dati di training “X” ed il target “y” (classificazione attesa). Lanciamo il codice ed il risultato è il seguente:

target [-1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
-1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
-1 -1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1]

Per comodità abbiamo classificato la prima tipologia di Iris in -1 e la seconda in 1. Il dataset. Come training dei dati prendiamo i primi 100 campioni.

Mostriamo il risultato sulle dashboard di nodered ed interpretiamo i risultati.

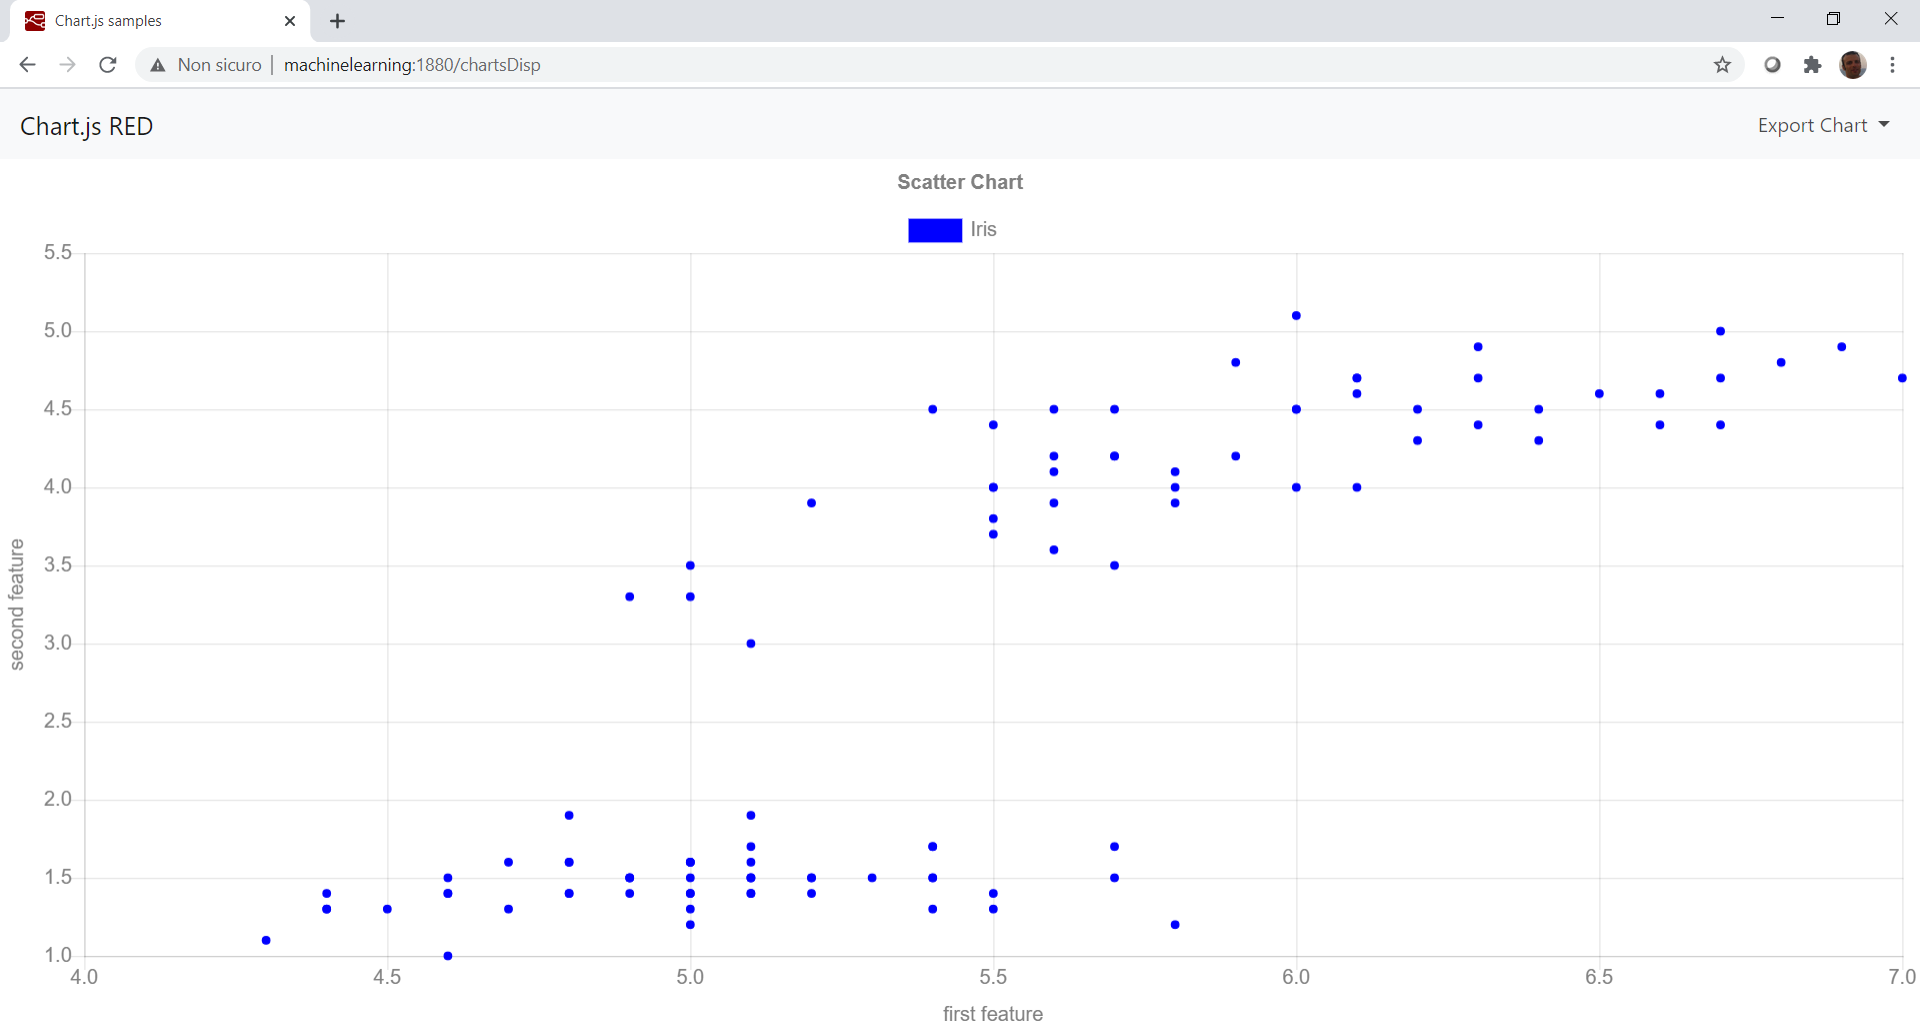
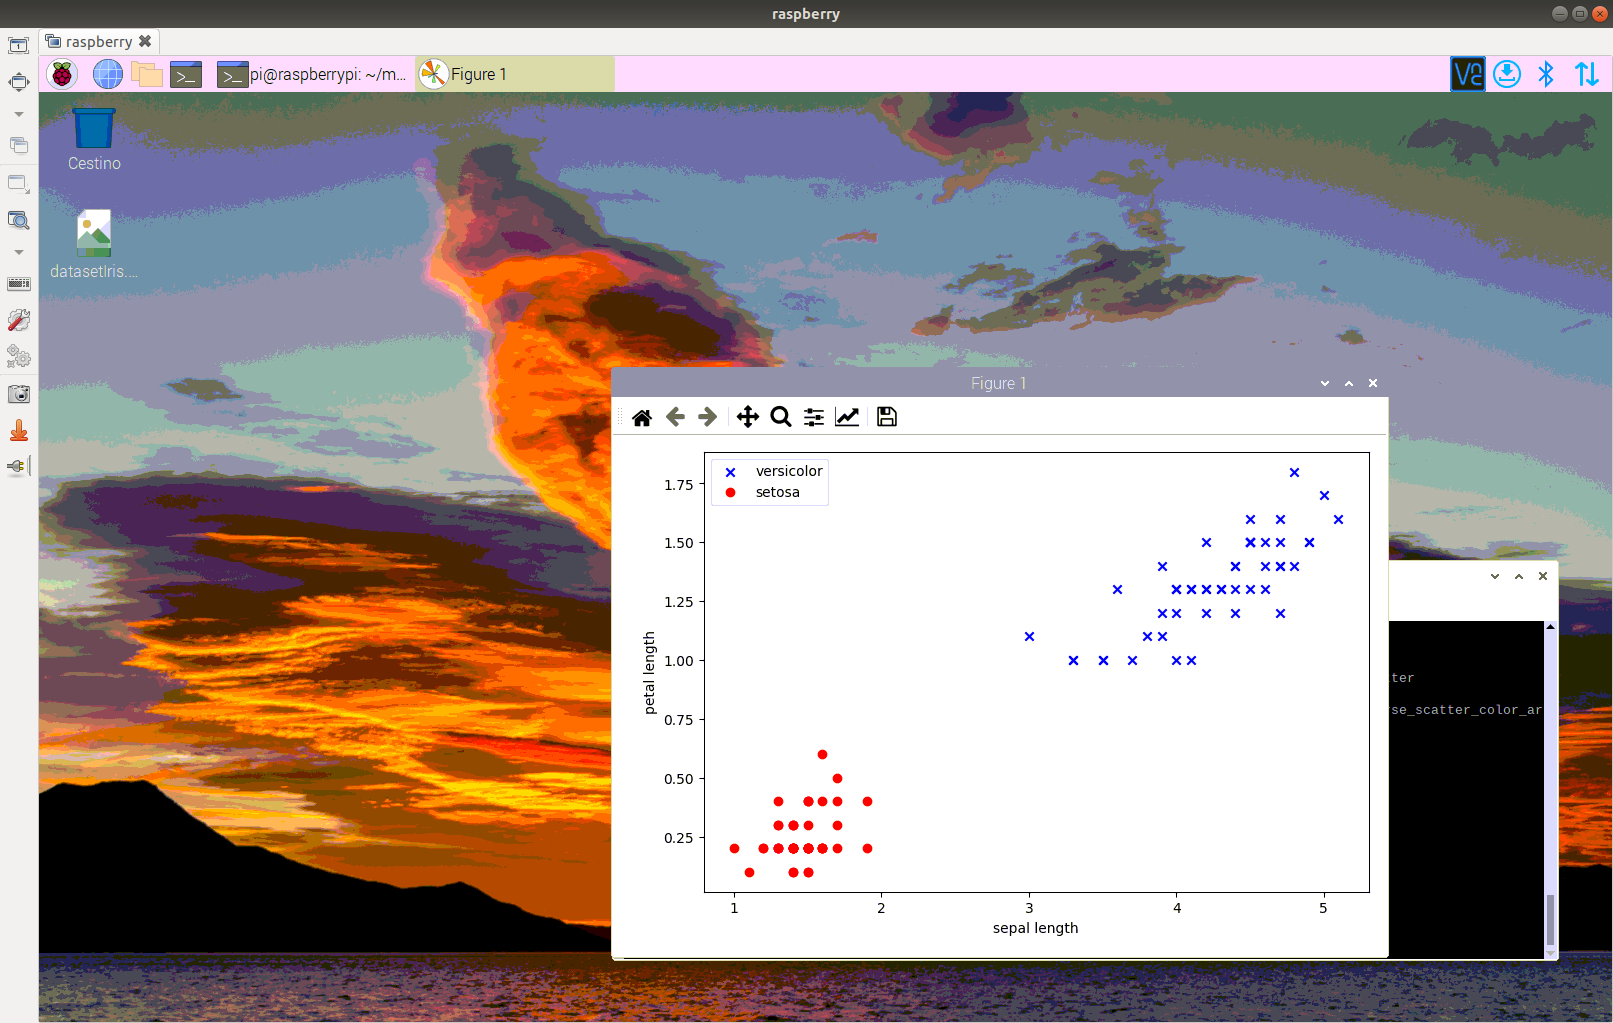
usiamo un grafico a dispersione per visualizzare il dataset inziale:

Come si vede nel grafico abbiamo una netta distinzione della classificazione binaria. La parte alta sono campioni relativi al target -1 mentre la parte bassa sono campioni relativi alla classe 1.

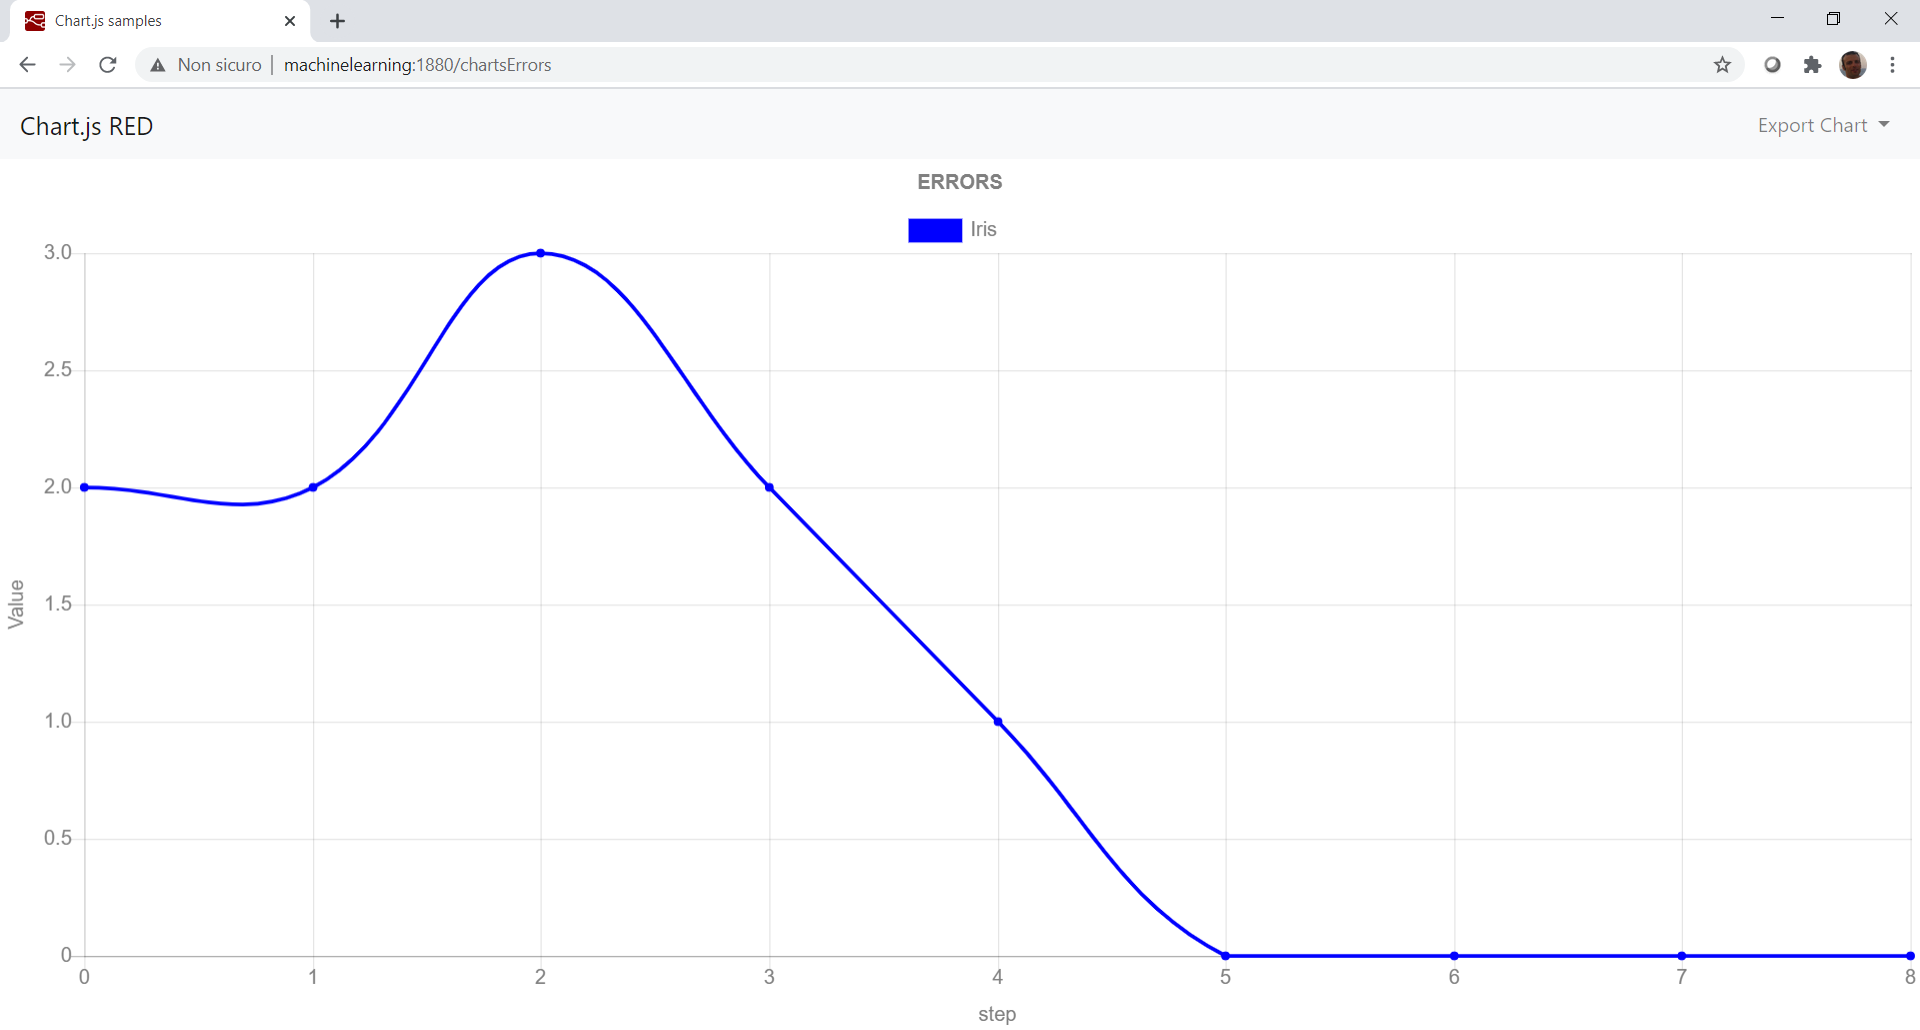
Proviamo ad importare questo dataset in modo da addestrare l’algoritmo. Per capire la precisione di classificazione dell’algoritmo dobbiamo osservare il grafico degli errori ad ogni step di apprendimento. L’algoritmo, inoltre, accetta due parametri in ingresso: il numero di iterazioni (i cicli nei quali si aggiornano i pesi) ed il tasso di apprendimento. Il risultato è il seguente:

Notiamo che dalla quinta iterazione l’errore si azzera, ciò vuol dire che già dalla quinta iterazione l’algoritmo è in grado di predire il risultato per ogni nuovo campione in ingresso.

Proviamo quindi la funzione predict con il campione: Y = np.array([4,1]), ovvero caratteristiche 4 e 1. L’algoritmo ci dovrà predire se sono caratteristiche di Iris-setosa oppure Iris-virginica.

  • print(“predict: ” perceptron.predict(Y))–> predict: -1
  • proviamo con Y = np.array([4,1]), predict: 1

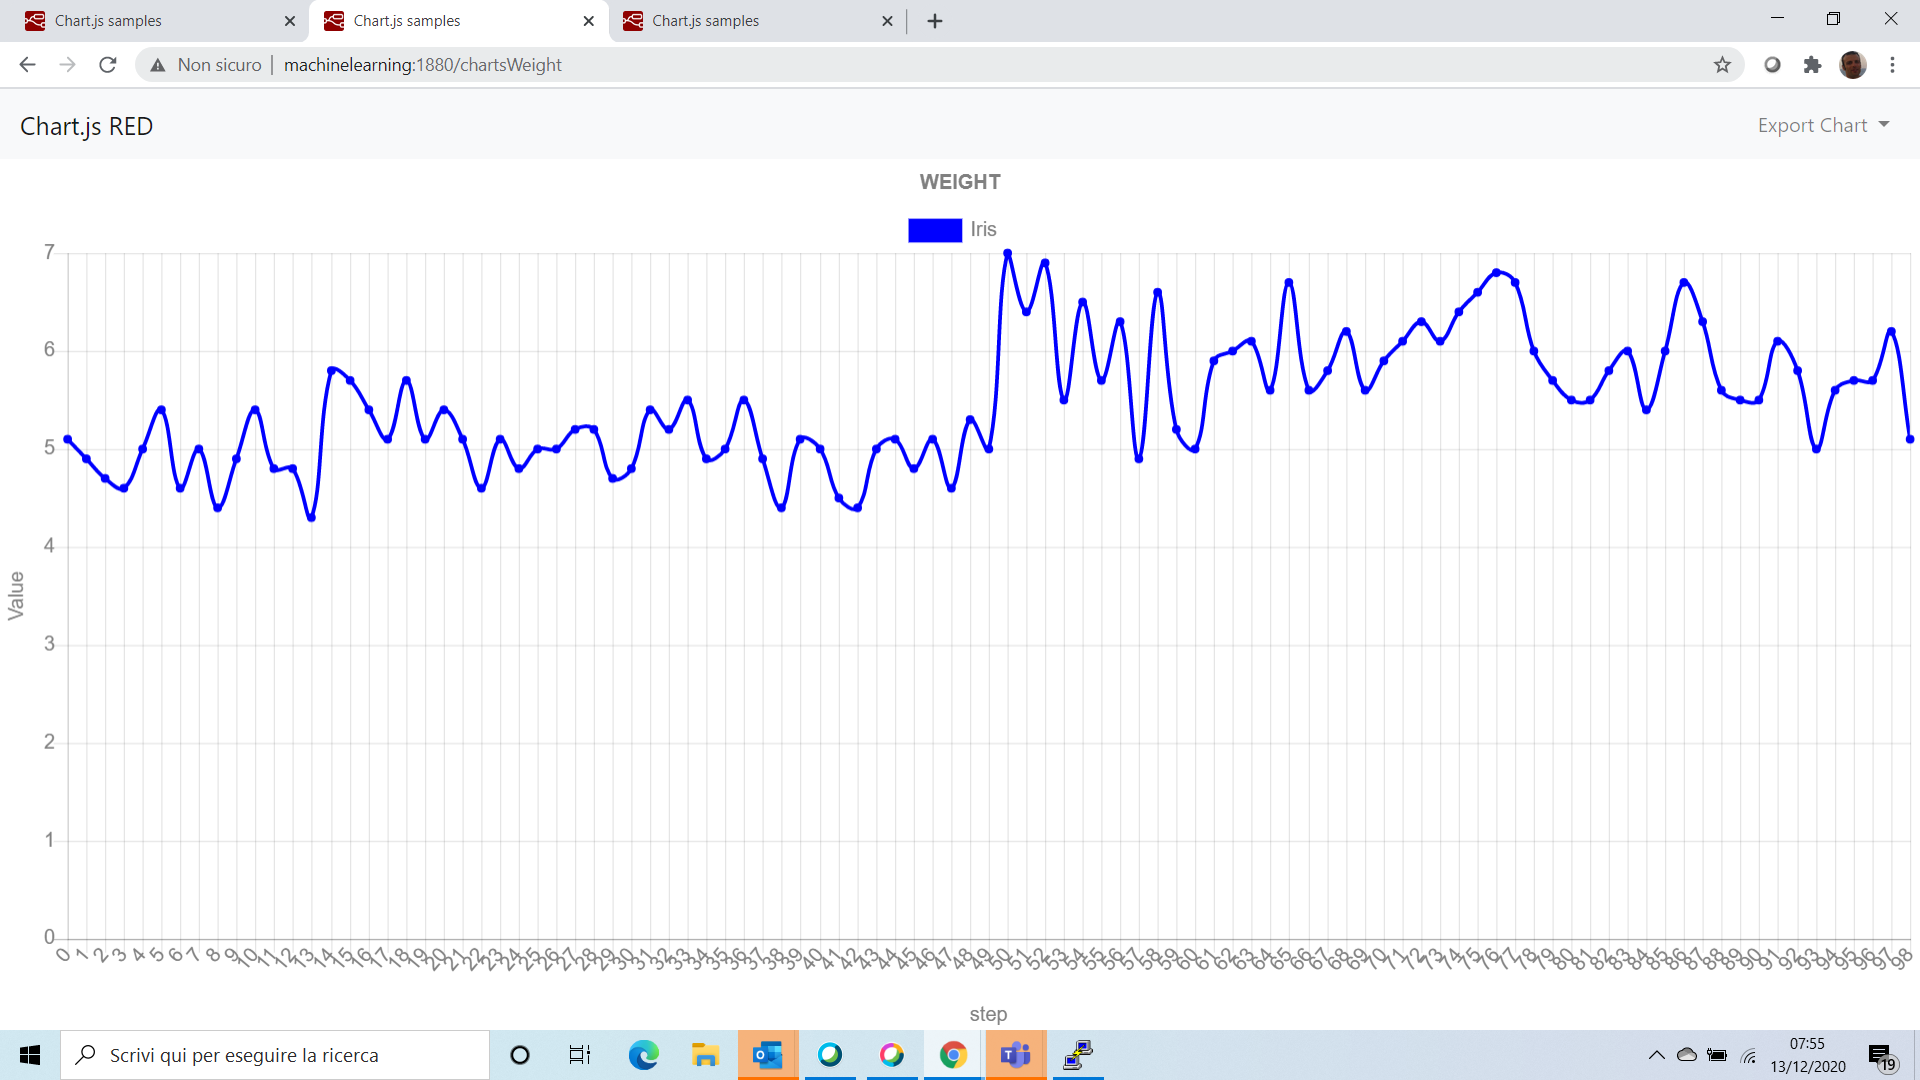
Un altro grafico interessante è l’andamento dei pesi ad ogni iterazione. Con questo grafico visualizziamo passo passo la correzione che l’algoritmo esegue sui pesi per migliorare la predizione.

variazione dei pesi su tutti campioni

PERCEPTRON: come simulare un neurone

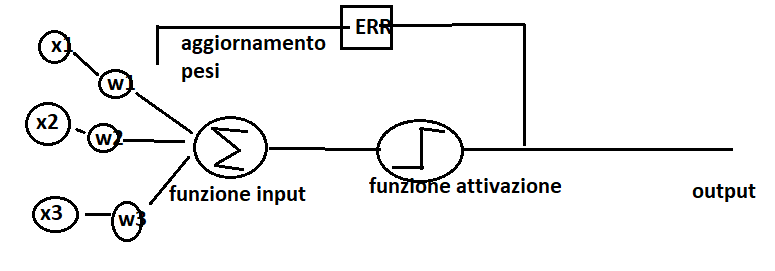
Immaginiamo di modellare un neurone artificiale come un elaboratore che può avere segnali in input e segnali di output. Il segnale entra attraverso i dendriti della cellula ed attraverso l’assone arriva fino ai terminali. Quando il segnale in input supera una determinata soglia allora si attiva il neurone e l’output è positivo. Al contrario l’output rimane negativo.

Il problema descritto sopra può essere rappresentato come un compito di classificazione binaria (+1; -1). I dati in ingresso entrano dentro l’elaboratore, che modelliamo con una funzione di attivazione Θ(z) e dove z è l’input della rete.

La funzione di attivazione che vogliamo utilizzare è a passo unitario, ovvero:

Avendo un serie di campioni che entrano nell’elaboratore (dataset) possiamo descrivere l’input in forma vettoriale:

z=w1 x1 + w2 x2 + w3 x3 + w4 x4 +…+ wm xm

wn-> pesi della funzione

x-> rappresentano le caratteristiche del campione e sono espresse in forma vettoriale

In linea teorica noi dovremmo trovare un algoritmo che dato in ingresso un serie di dati, classifica ogni campione sulla base delle caratteristiche. Il modello che intendiamo analizzare è un classificatore binario, quindi, preso in ingresso una serie di dati, in base alle caratteristiche, produce una classificazione binaria (1, -1).

Una volta “addestrato” il modello per produrre la classificazione binaria allora, ad ogni nuovo campione in ingresso, siamo in grado di predirne la classificazione (1, -1).

La classificazione è il risultato della funzione di attivazione che preso in ingresso l’input della rete si attiva soltanto se superiamo una determinata soglia θ:

Θ(z)=1 if z>=θ

Θ(z)=-1 altrimenti

oppure, in forma più compatta, portando la soglia alla sinistra dell’equazione:

Θ(z)=1 if z>=θ –> z-θ>=0

z-θ=w1 x1 + w2 x2 + w3 x3 + w4 x4 +…+ wm xm -> z= θ + w1 x1 + w2 x2 + w3 x3 + w4 x4 +…+ wm xm

L’ algoritmo perceptron che emula il neurone si comporterà come segue:

  1. inizializzazione dei pesi a 0 o numeri casuali piccoli
  2. calcolo del valore output y–: etichetta della classe prevista
  3. aggiornamento dei pesi: wj = wj + Δwj, dove Δwj=η(y(i) – y-(i))x(i)j

Dalle formule è evidente che se una predizione risulta errata allora l’aggiornamento del peso avviene in modo proporzionale nella direzione della classe target corretta.

Ad esempio, se abbiamo un campione x(i)j = 2 e l’abbiamo predetto nella classe errata y-(i)= -1 ed il tasso di apprendimento η=1, allora, l’aggiornamento del peso risulta essere:

Δwj=η(y(i) – y-(i))x(i)j = Δwj=1(1 – -1)2 = 4, l’algoritmo aggiorna i pesi in maniera proporzionale verso la classe corretta.

In conclusione, il perceptron, è un algoritmo di classificazione binaria in grado di predire una determinata classe attraverso le caratteristiche del campione.