come stanno cambiando i sistemi informatici?

In questo articolo vorrei fare una previsione di come cambieranno i gestionali aziendali o, in generale, i sistemi informatici nel prossimo futuro. Sul mercato iniziano a presentarsi alcuni prodotti di intelligenza artificiale in ambito dei sistemi informatici; quale di questi si affermerà come standard?

Sistemi informatici di supporto ai flussi operativi

I flussi operativi aziendali sono la sequenza delle attività che si susseguono tra i vari reparti o uffici. Le attività hanno un determinato numero di input e un determinato numero di output. Un output è l’input della prossima attività. Tra un’attività e l’altra esistono le transazioni o gli eventi.

L’intera catena delle attività permette lo scambio del flusso informativo.

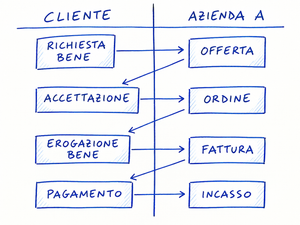
In un processo di vendita dell’azienda A, il flusso informativo inizia dalla richiesta del cliente, passa per l’erogazione del servizio o del bene, poi si procede con la fattura attiva e termina con il pagamento del servizio da parte del cliente. Il processo prevede una serie di attività e transazioni che passano dal cliente, poi dall’ufficio commerciale dell’azienda A, dal reparto produttivo di A fino all’amministrazione e alla tesoreria di A.
Ci sono diverse tipologie di sistemi operativi che supportano questo scambio informativo:

  • ERP (Enterprise Resource Planning): sistemi che supportano diverse aree aziendali in maniera centralizzata
  • sistemi applicativi verticalizzati: ad esempio, MES (gestione della produzione), MRP (gestione del fabbisogno dei materiali in magazzino), WMS (gestione del magazzino), sistemi costruiti adhoc…e così via. Questi sistemi, affinchè il processo informativo risulti automatizzato, necessitano di software specifici di integrazione.

Nel prossimo futuro, cosa potrebbe succedere per supportare questo scambio informativo? l’avvento dell’IA può trasformare gli attuali sistemi informatici?

Partiamo dal presupposto che la catena del valore nasce da una specifica esigenza del cliente che viene soddisfatta da un fornitore. Questo flusso è supportato attualmente da sistemi informatici tradizionali. Gli attuali sistemi informatici nascono per supportare questa catena del valore e renderla più affidabile dal punto di vista dei rapporti tra cliente e fornitore, dal punto di vista fiscale, dal punto di vista di efficienza operativa.

Cosa gestiscono esattamente i sistemi informatici?

risposta: documenti e la velocità e l’efficienza nel produrli, nel conservarli, nel recuperarli, nell’analizzarli, nel renderli privati, nel validarli.

I documenti possono essere di diverso tipo:

  • documenti operativi (contrattazioni, ordini, offerte, fatture tra cliente e fornitore…),
  • documenti fiscali (fatture elettroniche, DDT, scontrini, ricevute, libro giornale, registri IVA, ammortamenti…),
  • documenti legali (GDPR, privacy, dichiarazione rifiuti, sicurezza…)
  • …

I documenti oggi vengono creati sui sistemi informatici attraverso maschera di data entry. I sistemi gestionali di tipo ERP, ad esempio, automatizzano ed ottimizzano il processo di creazione dei documenti precompilando le maschere a partire dal documento precedente.

Cosa succederà con l’intelligenza artificiale?

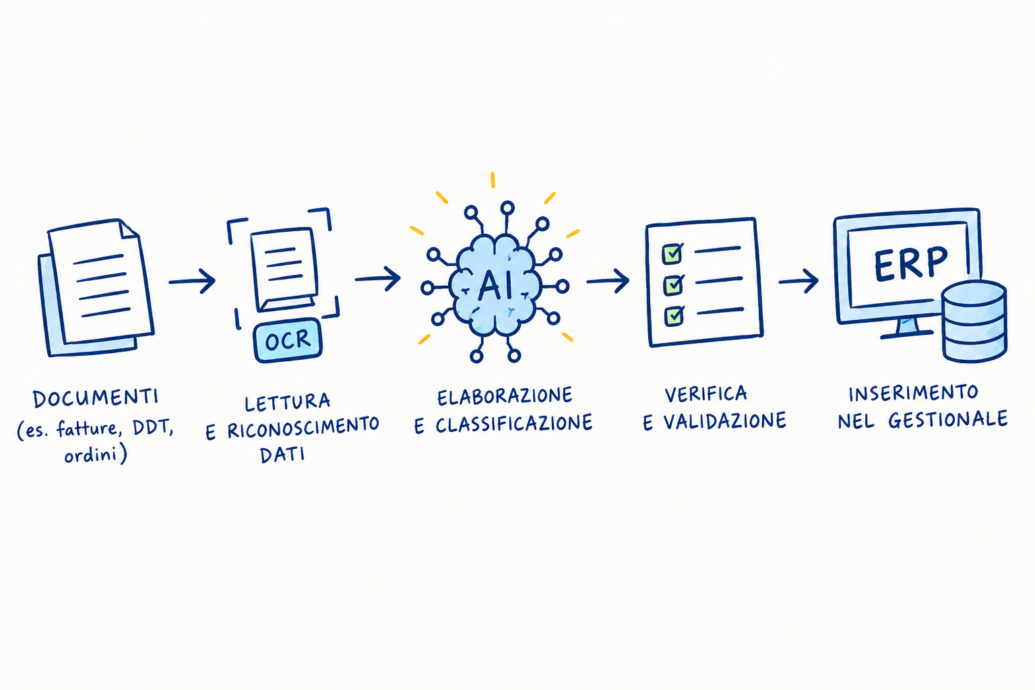
Sicuramente il primo intervento dell’intelligenza artificiale sarà sulla maschere di inserimento documenti. Le maschere saranno automaticamente compilate dall’intelligenza artificiale e l’operatore umano si limiterà a controllare e a validare i dati. L’umano rimarrà quindi responsabile di ciò che ha scritto l’IA.

A lungo andare, le maschere di inserimento si trasformeranno in maschere di controllo; più semplici visivamente e più facile da intervenire. Il frontend (l’interfaccia utente) si trasformerà in modo da rendere più semplice il controllo dei dati prodotti dall’IA. Inoltre, la qualità dei dati inseriti dall’IA migliorerà di volta in volta ad ogni superamento del controllo dell’umano.

Il database rimane un nodo centrale: permette la conservazione coerente dei dati in modo da renderli sempre fruibili ed affidabili. Il database conserva rigorosamente dati operativi e transazionali (dati che vengono prodotti con frequenza poichè legati direttamente ai processi operativi) e dati statici (come le anagrafiche prodotti, clienti, fornitori…)

Come fa l’intelligenza artificiale a compilare, nella pratica, le maschere di controllo?

attraverso la conservazione rigorosa dei dati operativi, l’intelligenza artificiale sarà in grado di produrre documentazione coerente con i documenti precedentemente generati e controllati da un umano.

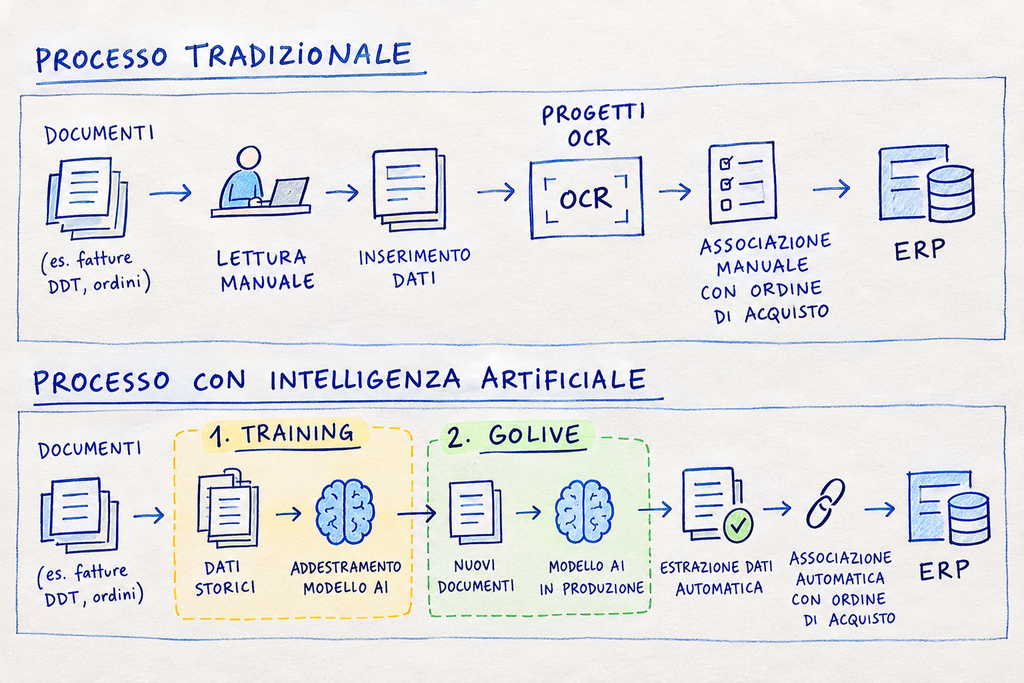
Ad esempio, in un processo di entrata merci, solitamente l’operatore crea il documento “entrata merci” sull’applicativo (nei casi più evoluti genera dall’ordine di acquisto in modo da avere alcuni dati già precompilati), scannerizza il barcode del DDT fisico, compila gli ultimi dati e conferma il documento. Con l’avvento dell’IA, durante la scansione con OCR il sistema riconoscerà automaticamente il documento precedente, lo integra con le informazioni del DDT e propone il documento nella maschera di controllo. L’operatore di magazzino dovrà solo confermare, rifiutare o correggere la proposta. Il sistema auto-apprenderà dalle decisioni dell’operatore in modo da essere più efficiente in futuro.

Qualcuno può pensare: le tecnologie esistono già! Se da un certo punto di vista quest’affermazione può sembrare vera, in realtà, l’intelligenza artificiale adotta lo stesso metodo in maniera scalabile anche su altri ambiti (fattura passiva da entrata merci, fattura attiva da spedizione…) senza attivare costosi progetti di automazione per ogni ambito. Questa proprietà dell’intelligenza artificiale sarà, a mio avviso, la leva per l’affermazione di prodotti AI sul mercato dei sistemi informatici.

Per poter funzionare al massimo delle capacità, questi algoritmi necessitano di un periodo di apprendimento dei documenti aziendali chiamato training, e soltanto dopo, potrà essere reso disponibile a tutti gli operatori che, con le loro convalide, migliorano di volta in volta l’algoritmo.
Sistemi informatici di supporto ai flussi direttivi e strategici

La classica business intelligence sta già subendo enormi cambiamenti. Non ci saranno più necessariamente software da imparare, ma tutto sarà lasciato sempre più nelle mani di chatbot che, anche attraverso la voce, esporranno dashboard e informazioni prendendo i dati aziendali direttamente dai sistemi informatici.

Lo scenario sarà una cosa del tipo: il direttore commerciale apre la chatbot “esperto analista” e chiederà: “mi mostri il volume delle vendite dell’ultimo triennio e le incroci con i costi indiretti dello stesso periodo?” oppure, “mi invii mensilmente il solito report dei forecast o previsioni di vendita?”. Ovviamente, l’utente non dovrà più imparare ad utilizzare un nuovo strumento e non avrà più bisogno di un analista esperto per creare le dashboard

Anche in questo caso si semplifica enormemente l’usabilità.

Nel caso in cui il risultato di un chatbot sia esattamente ciò che ci si aspetta, allora l’utente può accettare il risultato contribuendo a migliorare l’algoritmo e renderlo sempre più efficiente.

Il resto dell’infrastruttura, non subirà cambiamenti significativi: il datalake, il datawarehouse rimangono componenti importanti in un progetto di intelligenza artificiale.

Cosa succede quindi sul mercato?

A mio avviso i grossi player estenderanno le funzionalità direttamente sulle proprie applicazioni: SAP, Microsoft, Oracle… sfrutteranno la loro attuale infrastruttura e renderanno il data entry più semplice e meno impattante per l’utente. Si creeranno algoritmi che si adatteranno alle esigenze delle singole aziende man mano che gli operatori li useranno.

Le applicazioni di Business Intelligence subiranno un grosso cambiamento a livello di frontend

In generale, nel futuro ci si aspetta la creazione di modelli AI intelligenti adattati ad ogni esigenza aziendale attraverso training e validazione degli operatori.

I più comuni algoritmi di machine learning per fare previsioni di vendita

La previsione delle vendite è un aspetto fondamentale per le aziende che desiderano ottimizzare la gestione del magazzino, migliorare le strategie di marketing e massimizzare i profitti. Grazie al machine learning (ML), oggi è possibile fare previsioni sempre più accurate, basandosi su grandi quantità di dati storici e su algoritmi in grado di identificare pattern complessi.

In questo articolo, analizzeremo alcuni degli algoritmi di machine learning più utilizzati per le previsioni di vendita, mettendo in evidenza vantaggi e svantaggi di ciascuno.


  1. Regressione Lineare

La regressione lineare è uno degli algoritmi di machine learning più semplici e frequentemente utilizzati per prevedere vendite. L’algoritmo si basa sull’ipotesi che esista una relazione lineare tra una variabile dipendente (come le vendite) e una o più variabili indipendenti (come il prezzo del prodotto o la stagionalità).

Come funziona: La regressione lineare cerca di trovare la linea che meglio si adatta ai dati storici di vendita, minimizzando la distanza tra la linea e i dati osservati.

Vantaggi: Semplice da implementare e interpretare, è veloce e funziona bene con dati che presentano una chiara tendenza lineare.

Svantaggi: Non è adatto per dati complessi che presentano relazioni non lineari o variabili altamente correlate. Può sottoperformare rispetto a modelli più avanzati in presenza di molte variabili o stagionalità complesse.


  1. Random Forest

Il modello Random Forest è un algoritmo di apprendimento supervisionato basato su un insieme di alberi decisionali. Viene utilizzato sia per problemi di classificazione che di regressione, ma per le previsioni di vendita si utilizza principalmente per la regressione.

Come funziona: Random Forest costruisce una “foresta” di alberi decisionali su campioni casuali del dataset. Ogni albero genera una previsione e l’output finale è ottenuto mediando le previsioni di tutti gli alberi.

Vantaggi: È robusto e riduce il rischio di overfitting. È in grado di catturare relazioni complesse tra variabili e gestire grandi quantità di dati con molte caratteristiche.

Svantaggi: Tende ad essere più lento e richiede più risorse computazionali rispetto ad altri algoritmi, specialmente se ci sono molti alberi nella foresta. Non è ideale se si necessita di previsioni in tempo reale.


  1. Support Vector Regression (SVR)

La Support Vector Regression (SVR) è una variante della Support Vector Machine (SVM) applicata ai problemi di regressione. Questo modello si basa sulla definizione di un’area intorno alla linea di regressione all’interno della quale si tollerano piccole deviazioni.

Come funziona: La SVR cerca di minimizzare l’errore posizionando i dati all’interno di una “fascia di margine” definita intorno alla linea di regressione.

Vantaggi: È efficace per identificare pattern complessi, anche con un numero elevato di feature. È meno sensibile agli outlier rispetto alla regressione lineare.

Svantaggi: Può essere computazionalmente costoso e difficile da ottimizzare. L’interpretabilità è più complessa rispetto alla regressione lineare e richiede una buona comprensione dei parametri di modello.


  1. Reti Neurali Artificiali (ANN)

Le reti neurali artificiali sono particolarmente potenti per la modellazione di dati complessi e sono ampiamente utilizzate nel machine learning per la previsione delle vendite. Esse imitano il funzionamento dei neuroni umani e sono in grado di apprendere pattern non lineari e complessi.

Come funziona: Una rete neurale è costituita da strati di neuroni interconnessi. Attraverso un processo di addestramento, la rete aggiusta i pesi dei collegamenti per ridurre l’errore tra previsione e realtà.

Vantaggi: È in grado di catturare relazioni molto complesse, rendendola ideale per problemi di previsione di vendita con molti fattori influenzanti.

Svantaggi: Richiede una grande quantità di dati per addestrare il modello in modo efficace. Il processo di training è lento e complesso, e i modelli sono spesso visti come una “black box,” difficile da interpretare.


  1. Modelli di Serie Temporali (ARIMA e SARIMA)

ARIMA (AutoRegressive Integrated Moving Average) e SARIMA (Seasonal ARIMA) sono algoritmi specifici per l’analisi delle serie temporali, spesso utilizzati per la previsione di vendite storiche con trend e stagionalità.

Come funziona: ARIMA modella le vendite come una funzione autoregressiva (considerando valori passati) e una media mobile (considerando errori passati). SARIMA estende ARIMA per includere la stagionalità, aggiungendo una componente per gestire le variazioni periodiche.

Vantaggi: ARIMA e SARIMA sono efficaci per i dati con stagionalità ben definita e trend storico, sono interpretabili e ben consolidati.

Svantaggi: Non gestiscono bene i pattern complessi e i dati rumorosi. Sono più limitati in presenza di variabili indipendenti aggiuntive rispetto alla serie temporale pura.


  1. Gradient Boosting Machines (GBM)

Il Gradient Boosting è una tecnica di ensemble che costruisce una sequenza di modelli, dove ogni modello cerca di correggere gli errori del precedente. Algoritmi come XGBoost e LightGBM, basati su Gradient Boosting, sono molto popolari per la previsione delle vendite.

Come funziona: Ogni nuovo albero viene costruito per ridurre gli errori residui del modello precedente. La combinazione finale di alberi riduce progressivamente l’errore complessivo del modello.

Vantaggi: Altamente efficace su dataset complessi e in grado di catturare pattern intricati. Permette di gestire facilmente caratteristiche categoriali e numeriche.

Svantaggi: Come Random Forest, il Gradient Boosting è esigente in termini di risorse computazionali e può risultare difficile da interpretare per i meno esperti.


Come scegliere l’algoritmo giusto?

La scelta dell’algoritmo dipende da molteplici fattori:

Quantità e complessità dei dati: Se il dataset è grande e complesso, un modello basato su ensemble o una rete neurale potrebbe essere la scelta ideale.

Obiettivo e interpretabilità: Se l’interpretabilità è cruciale, la regressione lineare o i modelli di serie temporali come ARIMA potrebbero essere più appropriati.

Risorse computazionali: Alcuni algoritmi, come il Gradient Boosting e le Reti Neurali, richiedono più risorse rispetto a modelli più semplici.


Conclusioni

Il machine learning offre una vasta gamma di algoritmi per supportare la previsione delle vendite, da modelli semplici come la regressione lineare fino a tecniche avanzate come le reti neurali e il Gradient Boosting. Ogni metodo presenta vantaggi e limitazioni, e la scelta dipende dall’analisi dei dati a disposizione e dagli obiettivi aziendali.

In definitiva, la previsione accurata delle vendite non solo ottimizza i processi interni, ma permette anche di ottenere un vantaggio competitivo, facilitando la pianificazione e la gestione operativa a lungo termine.

Data Lake e Business Intelligence Potenziata dall’Intelligenza Artificiale: La Nuova Frontiera dell’Analisi Dati

Nel panorama sempre più complesso e competitivo della gestione aziendale, la capacità di raccogliere, elaborare e interpretare i dati è diventata fondamentale. I data lake e la business intelligence (BI) potenziata dall’intelligenza artificiale (IA) sono tra le tecnologie più innovative che consentono alle aziende di estrarre valore dai dati. Questo articolo esplorerà come queste tecnologie si integrano e quali vantaggi offrono.

Cos’è un Data Lake?

Un data lake è un sistema di archiviazione che permette di salvare enormi quantità di dati non strutturati e semi-strutturati in un unico luogo. A differenza dei tradizionali database relazionali, i data lake possono gestire dati di vario tipo e formato, come file di testo, immagini, video e flussi in tempo reale. Questa flessibilità consente di avere un repository centralizzato che raccoglie tutte le informazioni aziendali.

Vantaggi del Data Lake

  • Scalabilità: un data lake consente di gestire una mole di dati virtualmente illimitata, rendendolo ideale per aziende in crescita.
  • Flessibilità dei dati: è possibile caricare dati di qualsiasi tipo, anche non strutturati, senza bisogno di modellarli o organizzare tabelle.
  • Costi contenuti: rispetto ai data warehouse, i data lake sono generalmente meno costosi poiché utilizzano sistemi di archiviazione più economici, spesso su cloud.
  • Preparazione per l’analisi avanzata: grazie alla presenza di dati grezzi, i data lake facilitano l’uso di tecnologie di intelligenza artificiale e machine learning per analisi avanzate.

Business Intelligence (BI) e Intelligenza Artificiale (IA)

La BI tradizionale si concentra principalmente sulla raccolta e l’analisi dei dati per produrre report e dashboard, offrendo una visione retrospettiva sulle performance aziendali. Tuttavia, con l’introduzione dell’intelligenza artificiale, la BI ha acquisito un nuovo livello di potenza e precisione.

Cos’è la BI potenziata dall’IA?

Grazie all’integrazione con algoritmi di intelligenza artificiale e machine learning, la BI potenziata può elaborare grandi volumi di dati, identificare pattern nascosti e fare previsioni accurate. L’IA non si limita ad analizzare i dati storici, ma può anche applicare algoritmi predittivi e prescrittivi per aiutare le aziende a prendere decisioni proattive.

Vantaggi dell’IA nella BI

  • Analisi predittiva: gli algoritmi di machine learning possono analizzare i trend storici per fare previsioni accurate, come la domanda di mercato o i comportamenti dei clienti.
  • Automazione dei processi decisionali: i modelli IA possono identificare automaticamente le informazioni più rilevanti e presentarle sotto forma di insights pronti per l’uso.
  • Personalizzazione delle strategie aziendali: l’IA consente di adattare le strategie in tempo reale, identificando i micro-trend e le esigenze specifiche dei clienti.
  • Analisi in tempo reale: con l’ausilio di data lake e tecnologie di streaming, l’IA può processare dati in tempo reale, offrendo una BI dinamica e aggiornata.

Come Data Lake e BI con IA Lavorano Insieme

L’integrazione tra data lake e BI potenziata dall’IA crea una sinergia potente. I data lake fungono da repository centralizzati per tutti i dati, permettendo all’IA di accedere a una gamma più vasta di informazioni, con dati aggiornati e completi.

Flusso di lavoro tipico:

  1. Raccolta dei dati: il data lake raccoglie e organizza dati provenienti da diverse fonti, sia interni che esterni.
  2. Elaborazione con IA: i dati vengono processati e analizzati da modelli di machine learning che cercano pattern e anomalie.
  3. Analisi avanzata: l’IA utilizza questi dati per fare previsioni e fornire insights fruibili tramite la BI.
  4. Visualizzazione dei risultati: i risultati dell’analisi sono presentati attraverso dashboard e report personalizzati, rendendo le informazioni accessibili a tutta l’organizzazione.

Casi d’Uso di Data Lake e BI con IA

  • Customer Experience (CX): le aziende possono analizzare enormi volumi di dati dei clienti per personalizzare l’esperienza di acquisto e migliorare la customer journey.
  • Manutenzione predittiva: per aziende del settore industriale e manifatturiero, l’IA è in grado di prevedere malfunzionamenti e ridurre i tempi di fermo, abbattendo i costi operativi.
  • Ottimizzazione delle vendite e del marketing: i team di vendita possono beneficiare di insight predittivi per migliorare l’allocazione del budget, il targeting dei clienti e l’efficacia delle campagne.
  • Analisi del rischio: nel settore finanziario, l’IA può rilevare schemi sospetti e mitigare i rischi legati alle frodi.

Implementare Data Lake e BI con IA: Sfide e Best Practice

Sfide Principali

  • Qualità dei dati: il data lake raccoglie dati grezzi che spesso devono essere puliti e organizzati prima dell’analisi.
  • Sicurezza: con l’aumento dei dati centralizzati, aumenta anche il rischio di cyber-attacchi, rendendo fondamentale un buon sistema di protezione.
  • Gestione del cambiamento: l’introduzione dell’IA nella BI richiede competenze nuove e talvolta un cambiamento nella cultura aziendale.

Best Practice

  • Data Governance: stabilire regole chiare per la raccolta, la gestione e la condivisione dei dati.
  • Formazione continua: investire nelle competenze del team per un utilizzo efficace degli strumenti di BI con IA.
  • Scalabilità: adottare infrastrutture cloud per garantire che il sistema possa espandersi in linea con l’aumento dei dati.

Conclusione

La sinergia tra data lake e business intelligence potenziata dall’intelligenza artificiale rappresenta una nuova frontiera per le aziende che vogliono sfruttare al massimo il potere dei dati. Questo approccio offre vantaggi significativi in termini di capacità decisionale, adattabilità e anticipazione delle tendenze, trasformando i dati in un vero e proprio asset strategico.

Sfruttare data lake e BI con IA può dare alle aziende il vantaggio competitivo necessario in un mondo sempre più guidato dai dati.

Industria 4.0: Nodered + BPM + IdempiereERP + FlowItems


InformaticaGestionale.it ha trovato per voi una soluzione completamente opensource per la gestione dell’IIOT (industrial Internet Of Things). Una soluzione per la quale è possibile richiedere anche i super incentivi messi a disposizione dal governo.

Questa soluzione è l’insieme di diverse tecnologie open source riconosciute a livello internazionale:

IdempiereERP: classico ERP per la gestione di diverse aree aziendali in maniera centralizzata (centralizzazione ed ottimizzazione delle informazioni aziendali; dai dati di amministrazione, fino alla gesitone dei materiali ecc…)

IdempiereBPM: è un plugin installato sull’ERP Idempiere per la gestione dei flussi operativi, direttivi e strategici aziendali. E’ possibile assegnare una sequenza di stati a qualsiasi flusso informativo.

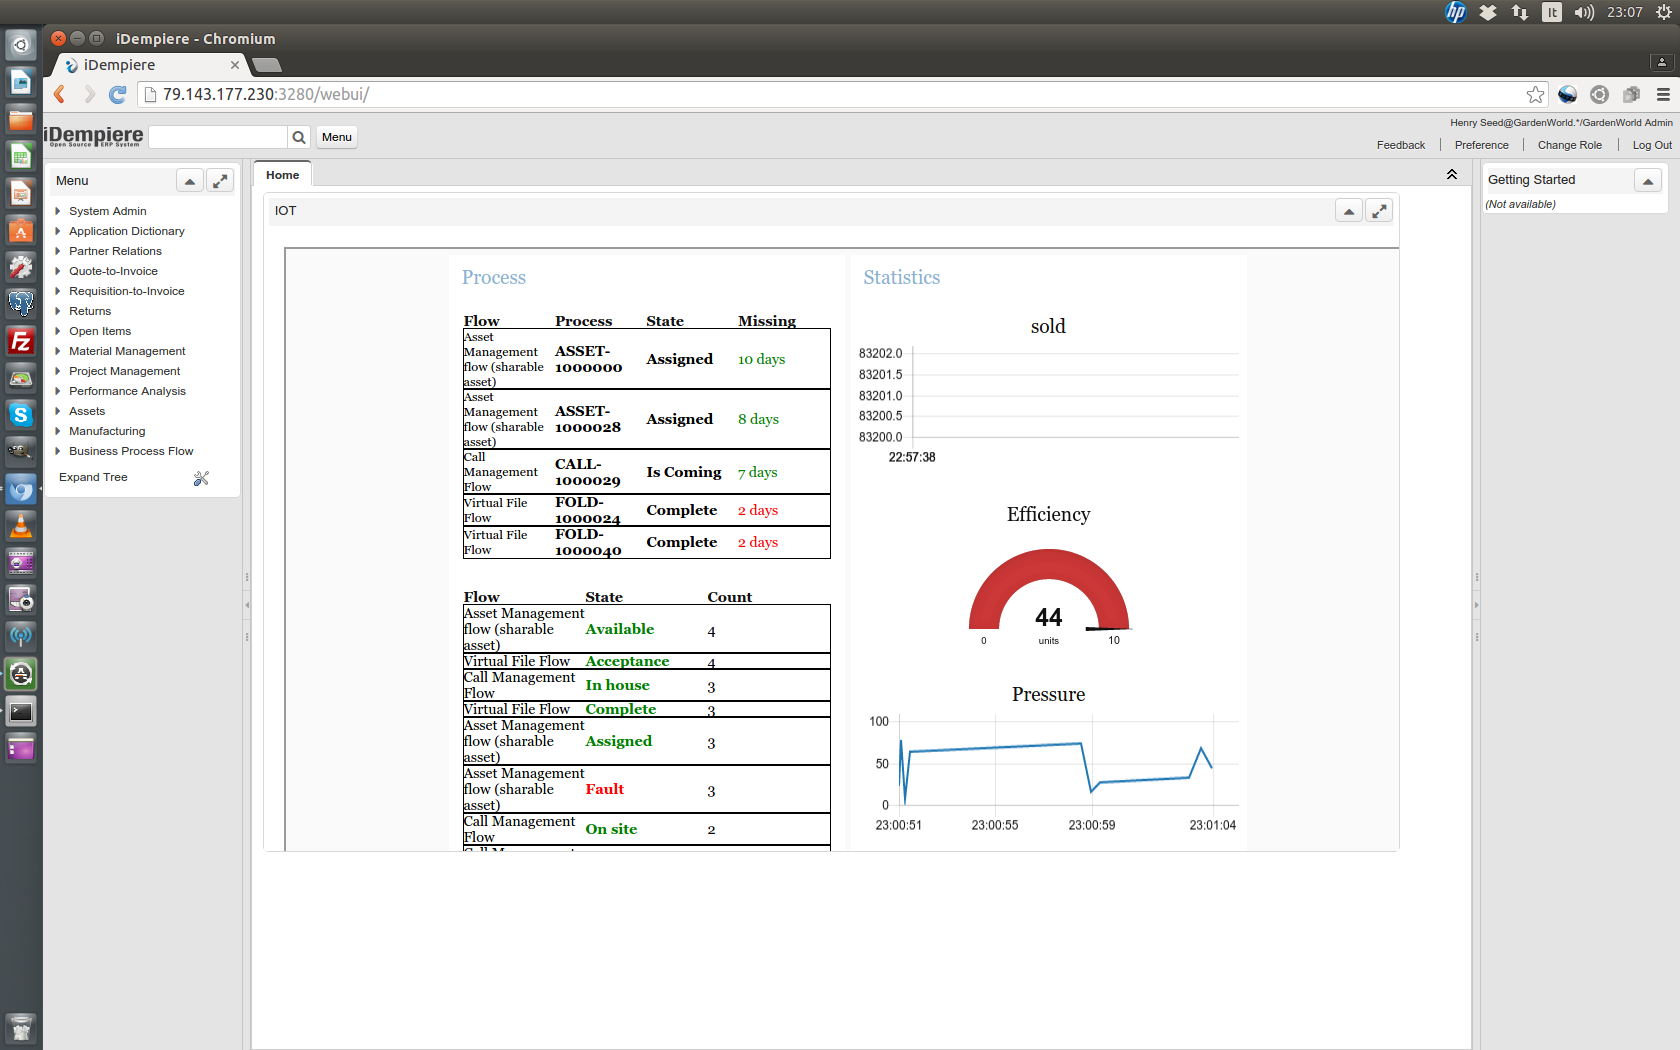
NodeRed: è il prodotto opensource che permette l’integrazione degli “oggetti” industriali al nostro ERP. Sfruttando il plugin IdempiereBPM è possibile assegnare un flusso di stati (con le condizioni di avanzamento) direttamente sugli oggetti (macchine industriali o asset aziendali)

FlowItems: è un’applicazione web-oriented per smartphone che rende più agevole l’accesso alle informazioni direttamente sugli “oggetti” aziendali attraverso NFC o QRCode.

grazie a questa soluzione i campi di applicazione possono essere di vario tipo: gestione dei beni aziendali, gestione delle macchine industriali, gestione di qualsiasi oggetto fisico che produce costi e ricavi per l’azienda, gestione stati di avanzamento, gestione dello storico di avanzamento.

E’ possibile integrare le funzionalità di un normale ERP (presenze dipendenti, turni di lavorazione, anagrafiche clienti e fornitori…) con la lavorazione delle macchine industriali oppure con asset e materiali di altro tipo.

per chi volesse approfondire

http://www.interofthings.com/contacts/


Asterisk, Voip Open Source

Dopo oltre dieci anni dalla sua nascita, Il software open source di Mark Spencer continua la sua crescita e si conferma come leader nel settore della telefonia “over IP”.

Che cosa fa

Asterisk è innanzi tutto un centralino telefonico basato su tecnologia Voice over Internet Protocol. Il suo ruolo principale è quindi quello di commutare le telefonate secondo diverse modalità.

E’ stato sviluppato con l’obiettivo principale di gestire chiamate VoIP, ma consente di interfacciarsi anche alle più comuni interfacce telefoniche tradizionali (ISDN, analogiche).

come si installa

Installare Asterisk è molto semplice.

Esistono diversi prodotti che permettono l’installazione di Asterisk insieme ad una suite di applicazioni che consentono di realizzare un centralino telefonico completo con strumenti che ne facilitano la gestione.

Uno dei più conosciuti è Trixbox.

fattori di successo

Gli elementi che hanno caratterizzato il successo di Asterisk sono le performance di switching della voce offerte dall’applicazione e la flessibilità garantita da una soluzione completamente Open-source.

Scenari d’uso

Per capire se Asterisk può fare al caso vostro si riportano di seguito alcuni possibili scenari realizzabili con questo straordinario strumento.

Full IP

Il seguente scenario non richiede nessun hardware aggiuntivo.

E’ sufficiente installare la suite asterisk su un PC e collegare lo stesso ad internet.

Sarà possibile collegare il centralino telefonico alla PSTN utilizzando un provider VoIP.

I provider VoIP infatti consentono la commutazione delle chiamate telefoniche tradizionali (che viaggiano quasi interamente tramite protocolli TDM) verso il mondo internet.

Per potersi collegare ad un provider VoIP è sufficiente registrarsi al servizio e seguire le istruzioni pubblicate dal fornitore.

In seguito alla registrazione il provider fornirà i parametri per la configurazione di un “Trunk SIP”, ovvero un collegamento telefonico VoIP tra il vostro centralino ed il provider.

Tra i parametri di configurazione ci sarà anche un numero di telefono, che sarà il numero da cui sarà possibile ricevere le chiamate.

Si riporta di seguito il collegamento ad un noto provider VoIP.

http://www.euteliavoip.com/index.php?lang=en

architettura soluzione Full IP

Leggi tutto

Creazione report Adempiere con JasperReport

Abbiamo già visto come creare qualsiasi report utilizzando un motore interno di Adempiere. In realtà è possibile creare report più complessi e personalizzati utilizzando uno strumento indipendente chiamato jasperReport. In questo articolo faremo vedere come è possibile integrare un report creato in jasper all’interno di Adempiere.

Come esempio prenderemo un report già creato con IReport all’interno di questo articolo.

Leggi tutto

creazione report per gestionali con JasperReport

medium economic 2 days

Una delle funzionalità più importanti presenti nei gestionali è la creazione e la personalizzazione di qualsiasi report: fatture, DDT, ordini di vendita e qualsiasi altro documento.

Ad esempio, in Adempiere esiste un motore interno che permette la creazione dei report a partire da ogni singola maschera del gestionale.

Con questo tutorial mostriamo, invece, come creare un report con un alto grado di personalizzazione utilizzando JasperReport, uno strumento esterno ad Adempiere (o ad un altro gestionale). Tutto questo è possibile farlo senza essere specializzati in programmazione ma semplicemente conoscendo qualche nozione di linguaggio SQL.

Leggi tutto