A cosa serve la Business Intelligence?

In questo articolo parleremo degli strumenti di analisi delle informazioni per pura necessità di Business.

Come avevamo spiegato ormai diversi anni fa su questo articolo di questo blog, vi era in atto una trasformazione del web non più inteso come raccolta di documenti ma come pura raccolta di dati.

In tutto il decennio appena trascorso sono aumentati a dismisura gli applicativi che generano dati: cose, animali, piante e persone generano ogni giorno milioni di dati attraverso qualsiasi tipo applicativi di qualsiasi natura (IoT, Industria 4.0, social, web, forum, ecommerce, ERP…).

Ai tempi della scrittura di questo articolo avevo posto una domanda: 

politica di apertura o di chiusura delle informazioni aziendali (ovviamente non parliamo delle informazioni riservate dei dipendenti o coperte da GDPR)? la risposta l’avremmo ricevuta soltanto in futuro. Oggi possiamo certamente dire che le aziende, per cogliere maggiori opportunità di business, sono quasi obbligate a condividere tutte le informazioni con il pubblico. Il cliente, ad esempio, è abituato da tempo a leggere le recensioni che descrivono la qualità di servizio o del prodotto. Se un’azienda, che lancia un prodotto, non prevede la possibilità di acquisire recensioni allora potrebbe avere minori opportunità di business.

Il discorso non vale solo per l’apertura dei dati verso il grande pubblico (dipende molto dal tipo di business) ma, in generale, dalla condivisione verso uno o più partner esterni all’organizzazione; per cogliere, ad esempio, le opportunità del cloud le aziende devono accettare di esporre i propri dati presso i partner provider.

Quando si parla di condivisione dati si sottintendono logiche di interfaccia applicativa o integrazioni che ogni azienda deve governare ed implementare. Sono esplosi quindi sistemi applicativi di ETL (Extract/Transform/Load).

Oggi quindi, andando oltre, la domanda che le organizzazioni devono porsi sarebbe: 

con tutta questa mole di dati riesco a creare informazioni utili e, di conseguenza, valore per la mia organizzazione?

In questi anni sono nate terminologie come data scientist, BigData, DataLake, data integrator… che hanno come unico scopo la progettazione e lo sviluppo di applicativi per rispondere alla domanda sopra.

Esistono quindi persone e tecnologie che, seguendo una determinata strategia, riescono a rispondere tranquillamente alla domanda che abbiamo fatto sopra. Da una parte ci sono evidenti vantaggi di riduzione dei processi decisionali e dall’altra un utilizzo intelligente dei dati attraverso algoritmi che se usati bene offrono spunti per nuove opportunità di business.
Adaline: ottimizzazione con la normalizzazione del dataset

Prendendo spunto dal paragrafo precedente per ottimizzare l’algoritmo di Adaline in modo che la funzione costo venga minimizzata in maniera più veloce allora è possibile standardizzare l’intero dataset con la normalizzazione delle caratteristiche.

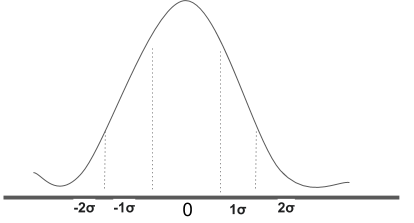
In che modo possiamo normalizzare? usando la distribuzione normale standard. la distribuzione normale standard prevede

distribuzione normale standard

Per normalizzare il dataset basta prendere ogni caratteristica, sottrarla per la media della distribuzione normale μ e dividere tutto per la deviazione standard σ

Ad esempio, per standardizzare la caratteristica j-esima è necessario prima sottrarre la media μj poi dividere per σj .

x‘j = (xj – μj)/σj

Addestriamo ora lo stesso algoritmo Adaline utilizzato nel paragrafo precedente con il dataset normalizzato. La libreria numPy ha già funzioni per calcolare la deviazione standard e la media.

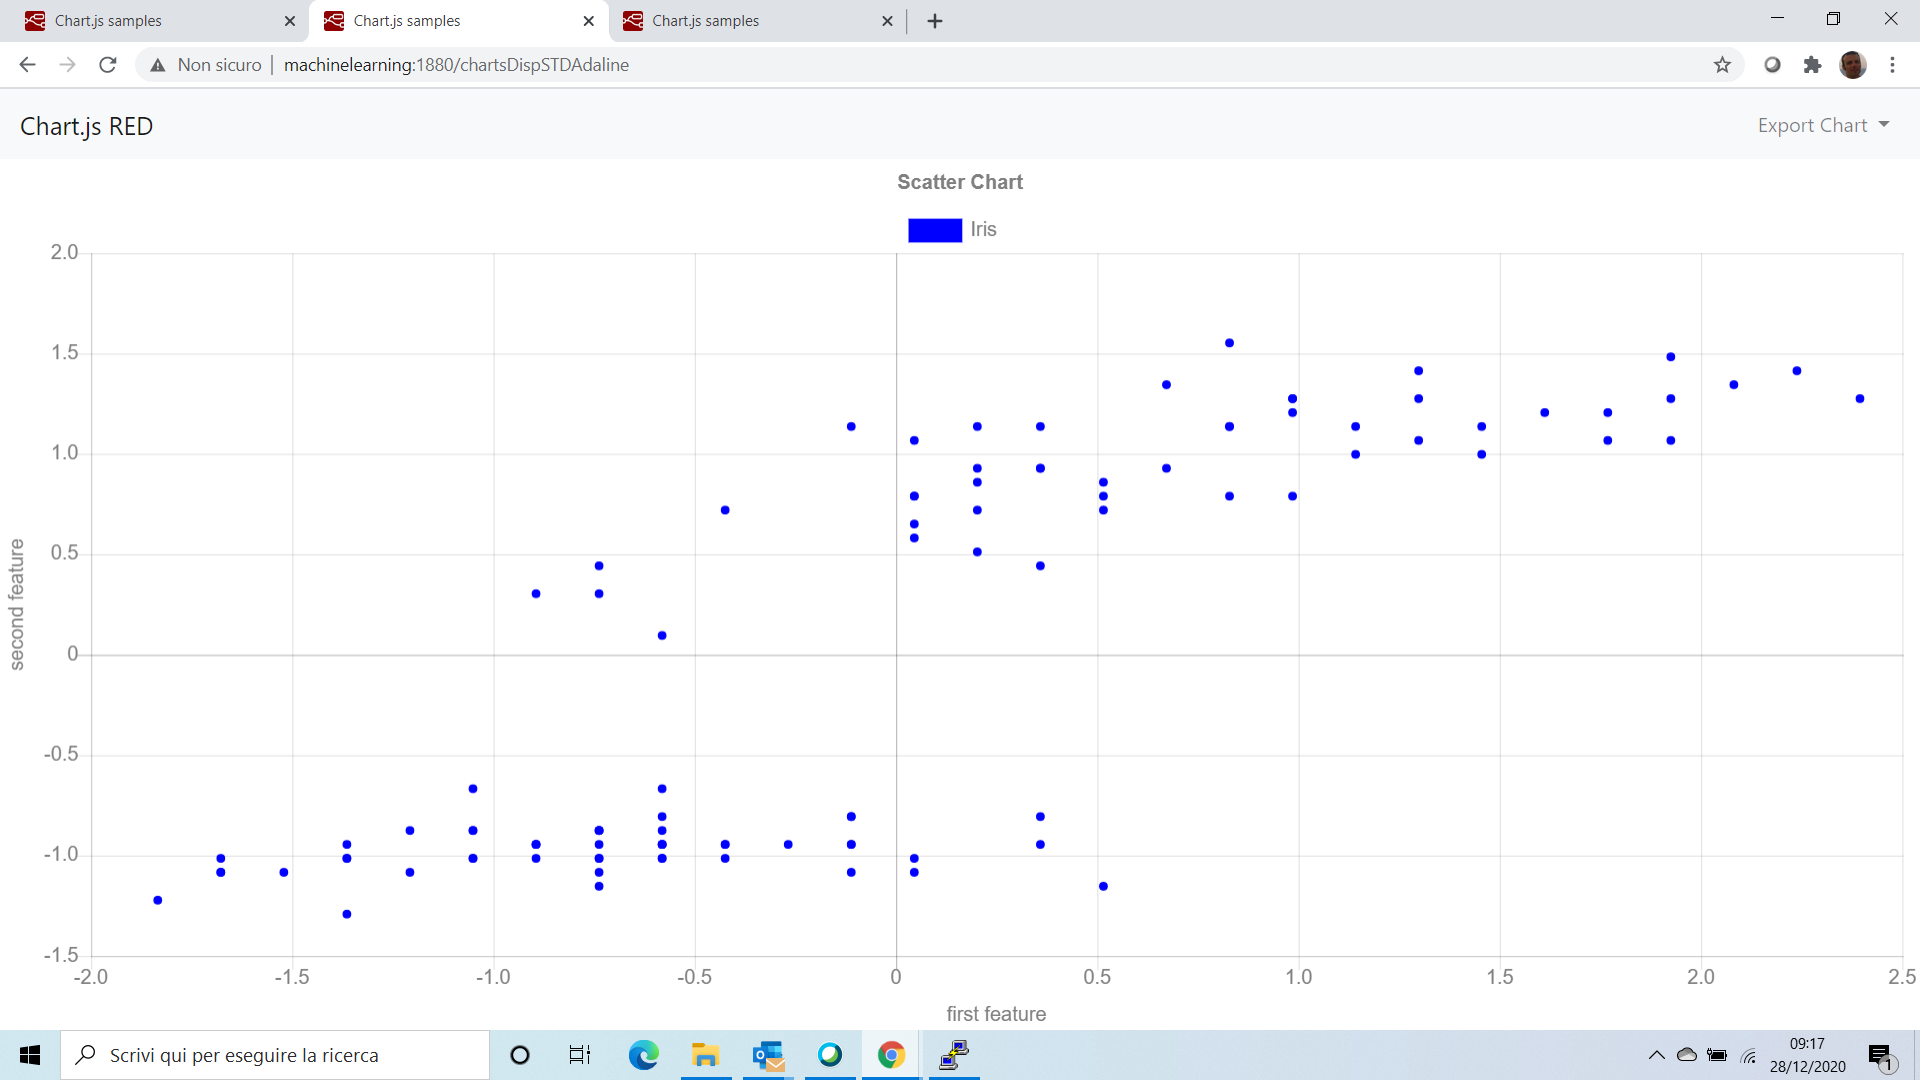
Anzitutto vediamo nel grafico i valori normalizzati,

dataset normalizzato

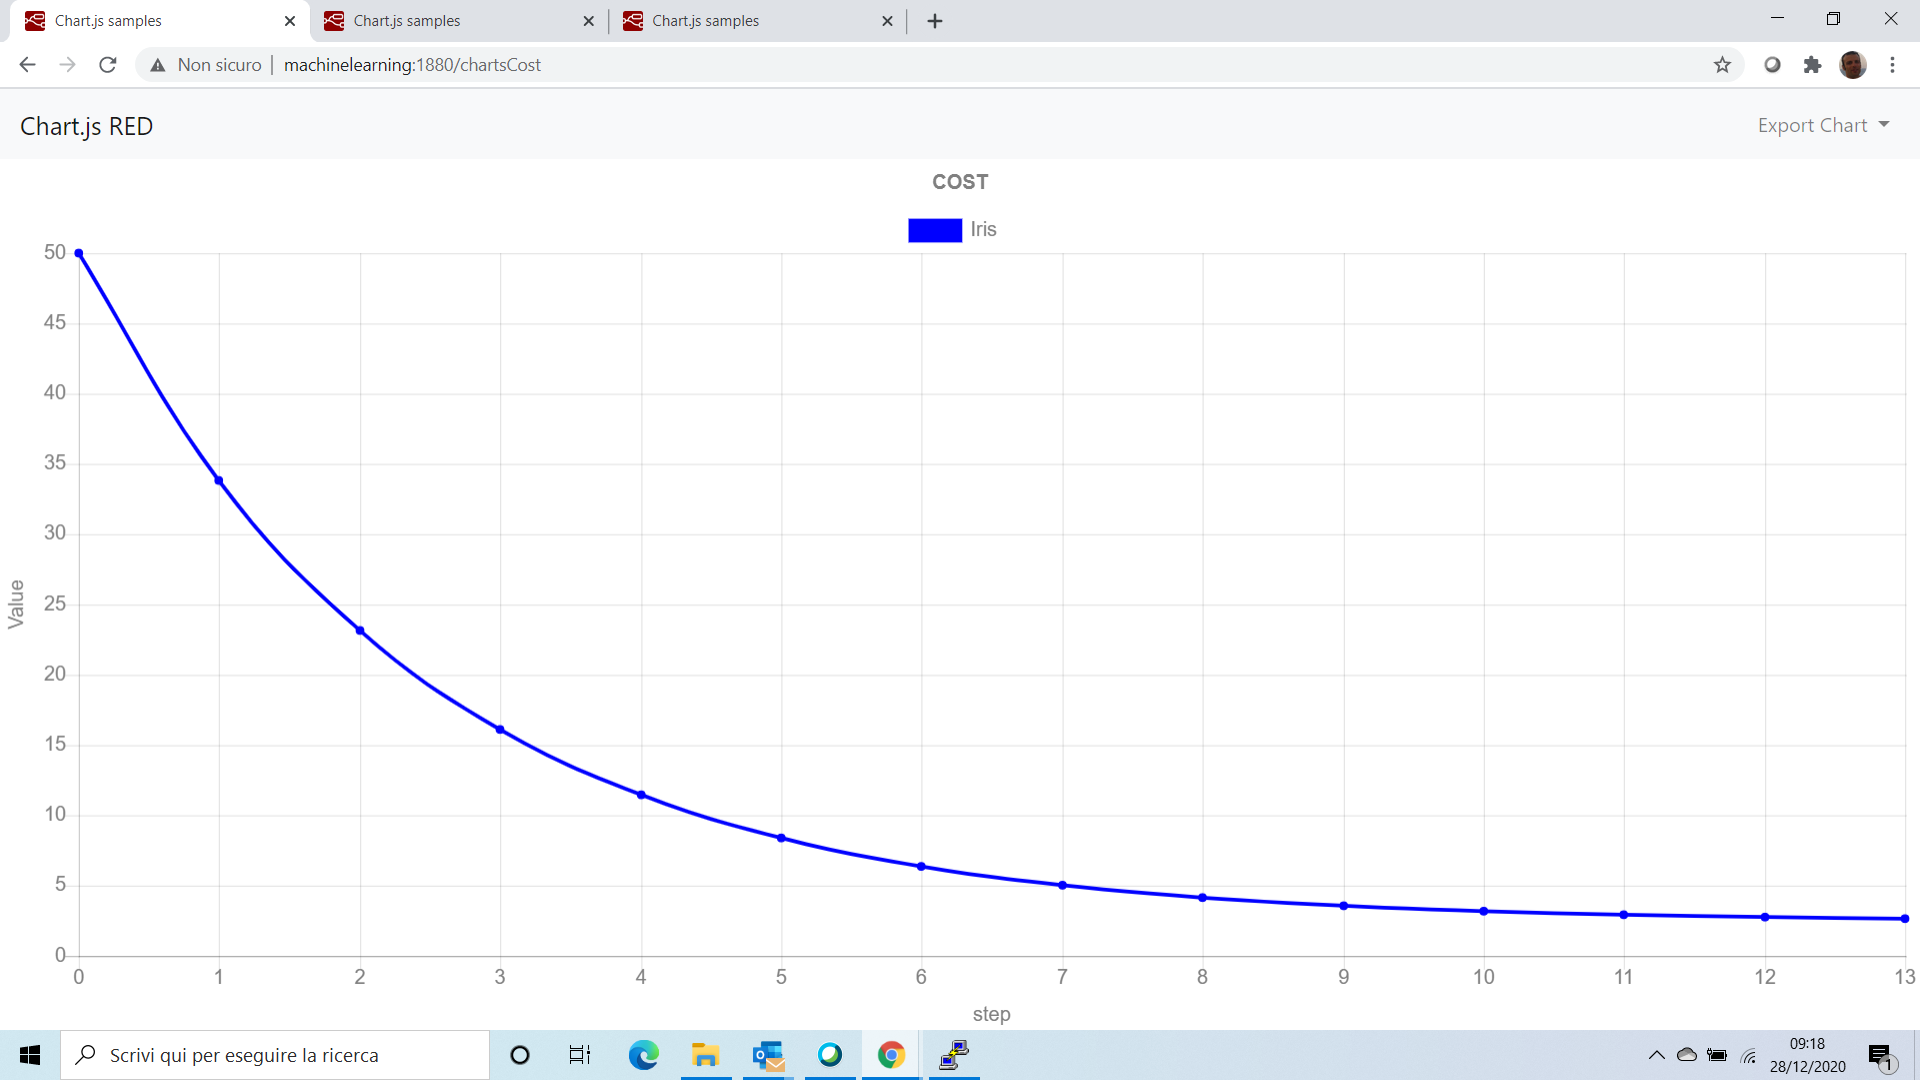
Addestriamo l’algoritmo con questi dati, dopo di che, osserviamo il grafico dei costi

pn = Adaline(0.01, 15)
pn.fit(X_std, y)

funzione dei costi

Il grafico mostra chiaramente la convergenza della funzione dei costi a fronte di un dataset normalizzato.

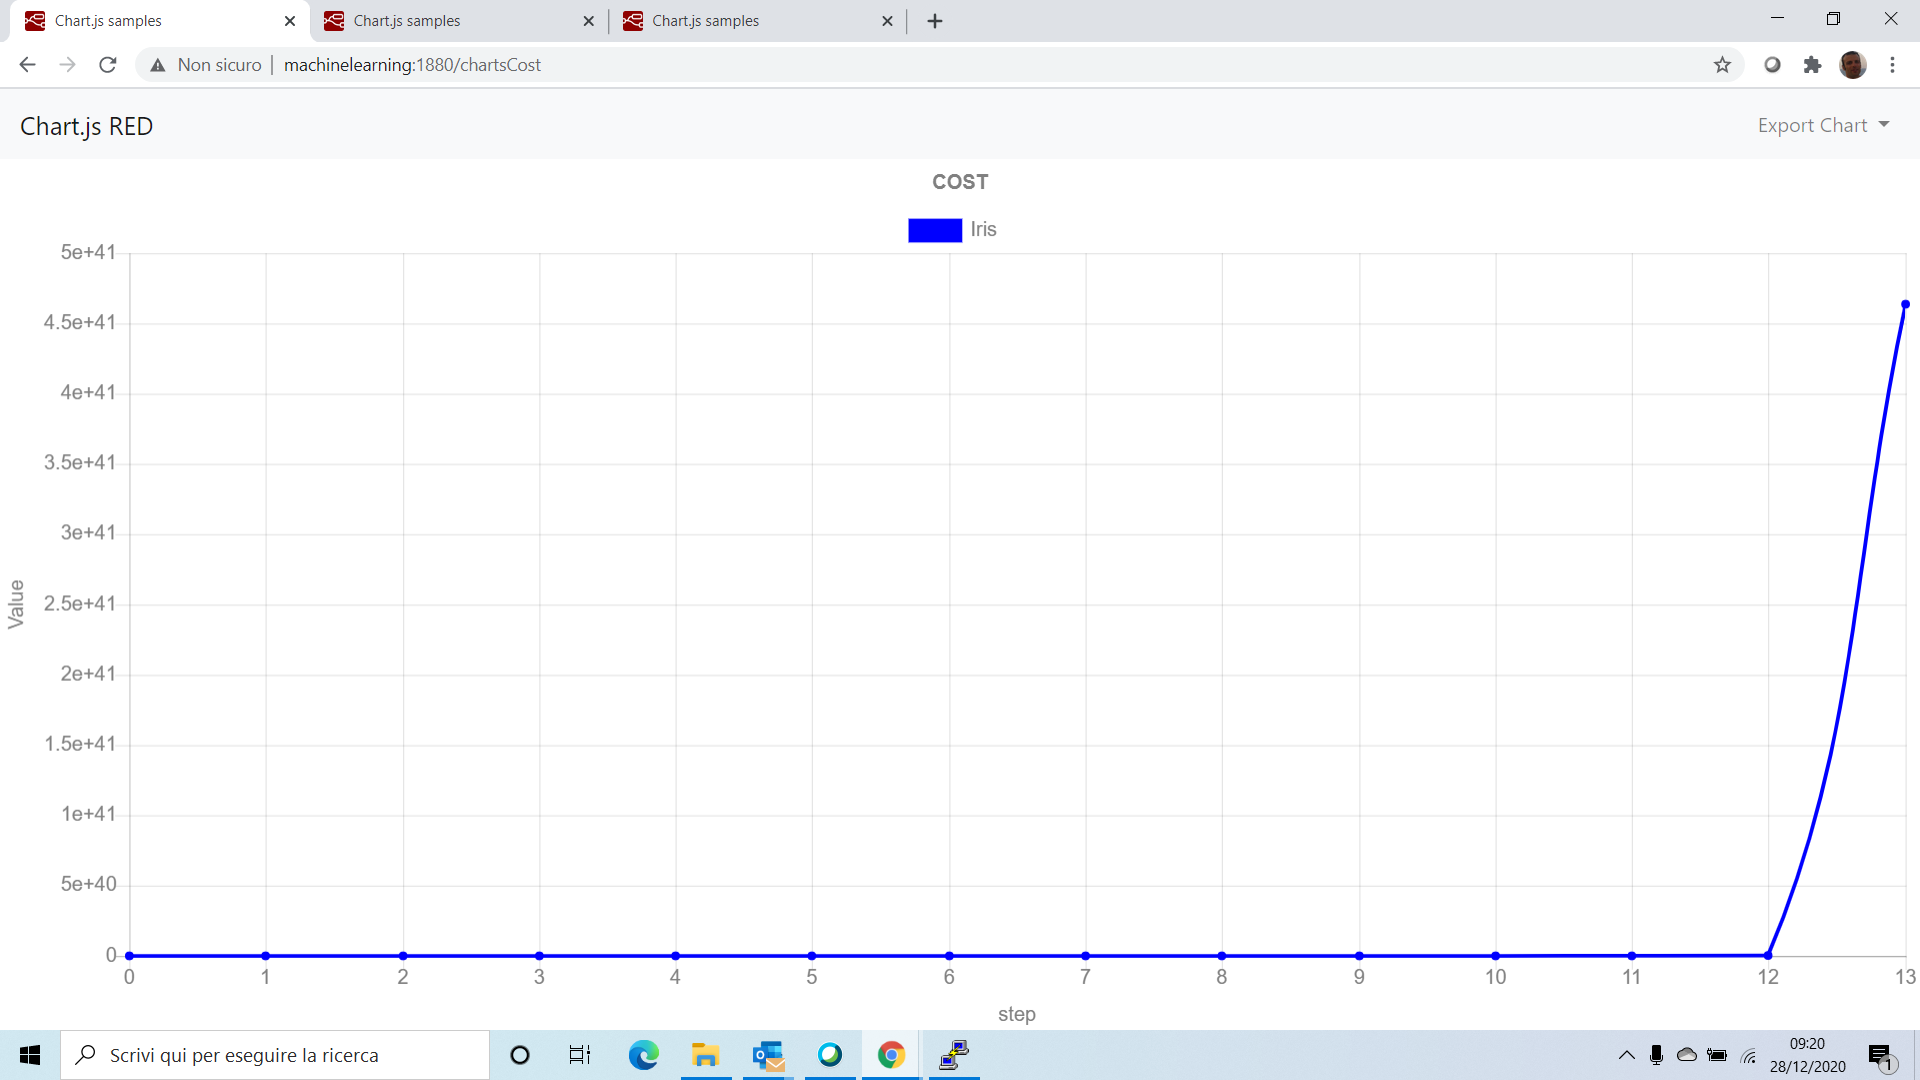
Giusto per fare un confronto mostriamo lo stesso grafico dei costi addestrando l’algoritmo con il dataset non normalizzato.

funzione di costo con dataset non normalizzato

Come volevasi dimostrare, la funzione di costo viene nettamente ottimizzata utilizzando il dataset normalizzato.

Adaline: MachineLearning con supervisione, algoritmo adattivo lineare

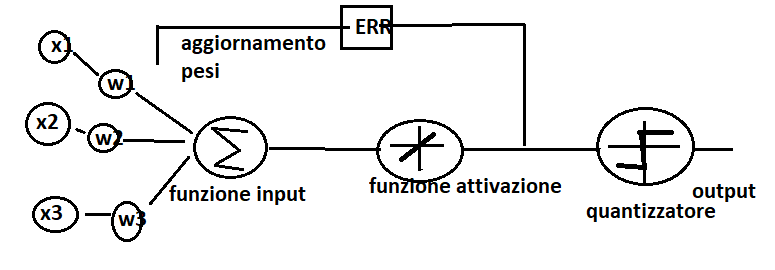
L’algoritmo Adaline (ADaptive LInear NEuron) è un algoritmo di convergenza dell’apprendimento. Ciò vuol dire che i pesi non si aggiornano ad ogni epoch sulla base di una funzione di attivazione binaria (come nel caso del Perceptron), ma si aggiornano sulla base di una funzione di attivazione lineare.

Come vediamo nel grafico sopra, la differenza con l’algoritmo Perceptron è che i pesi si aggiornano attraverso una funzione lineare ad ogni epoch. Questo consente di minimizzare la funzione di costo.

La funzione di costo è la funzione J che apprende i pesi in termini di somma dei quadrati degli errori (Sum Squared Errors – SSE) fra il risultato calcolato e la vera etichetta della classe.

J(w) = 1/2 Σi (y(i) – Φ (z(i)))2

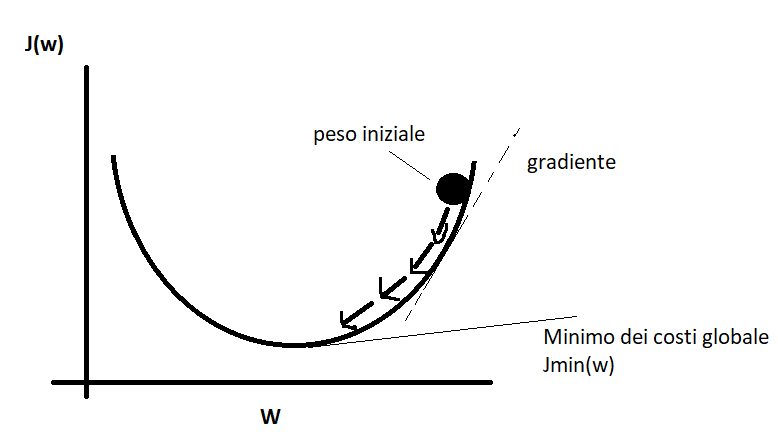
Quali sono i vantaggi di questa funzione? Questa funzione di costo è differenziabile ed è convessa. Questo ci consente di utilizzare un algoritmo di discesa del gradiente per trovare i pesi che minimizzano la funzione di costo.

Come si può vedere nel grafico sopra, i pesi si aggiornano in base alla funzione di costo descritto in precedenza. A partire quindi da un peso iniziale (w), i pesi si aggiorneranno fino a raggiungere il minimo dei costi globale ed allontanandoci quindi dal gradJ(w)

Il cambiamento del peso è definito in questo modo:

Δ(w)= -η gradJ(w)

Per calcolare il gradiente è necessario fare la derivata parziale della funzione J ad ogni peso wi. Il vantaggio dell’algoritmo è che i pesi vengono aggiornati simultaneamente a differenza del Perceptron che venivano aggiornati ad ogni iterazione.

Perceptron: MachineLearning con supervisione e funzione di attivazione

In questo paragrafo spiegheremo come utilizzare l’algoritmo perceptron implementato con Python a partire da un dataset di dati utilizzati principalmente per la studio del machineLearning: l’insieme di caratteristiche che definiscono delle tipologie di fiori Iris.

Iniziamo con l’implementazione del perceptron.py (l’algoritmo spiegato nell’articolo precedente) definendo i metodi fit (per l’apprendimento) e prediction (per la previsione dei nuovi dati)

il dataset iris è una serie di dati, solitamente a matrice, che come righe si ha il numero dei campioni e sulle colonne le caratteristiche per ogni campione.

esempio:
0 5.1 3.5 1.4 0.2 Iris-setosa
1 4.9 3.0 1.4 0.2 Iris-setosa
2 4.7 3.2 1.3 0.2 Iris-setosa
3 4.6 3.1 1.5 0.2 Iris-setosa
4 5.0 3.6 1.4 0.2 Iris-setosa
.. … … … … …
145 6.7 3.0 5.2 2.3 Iris-virginica
146 6.3 2.5 5.0 1.9 Iris-virginica
147 6.5 3.0 5.2 2.0 Iris-virginica
148 6.2 3.4 5.4 2.3 Iris-virginica
149 5.9 3.0 5.1 1.8 Iris-virginica

Il problema che vogliamo risolvere è: dato un campione di dati con determinate caratteristiche, a quale classe corrisponde? Iris-setosa oppure Iris-virginica?

la prima cosa da fare è inputare all’algoritmo perceptron il set di dati.

from perceptron import Perceptron

pn = Perceptron(0.1, 10)
pn.fit(X, y)

print(“dataset”,df)
print(“target”,y)
print(“training”,X)

print(“errors”,pn.errors)
print(“weight”,pn.weight)

Una volta importato l’algoritmo perceptron utilizziamo la funzione di apprendimento “fit” imputando il set di dati di training “X” ed il target “y” (classificazione attesa). Lanciamo il codice ed il risultato è il seguente:

target [-1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
-1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1 -1
-1 -1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1]

Per comodità abbiamo classificato la prima tipologia di Iris in -1 e la seconda in 1. Il dataset. Come training dei dati prendiamo i primi 100 campioni.

Mostriamo il risultato sulle dashboard di nodered ed interpretiamo i risultati.

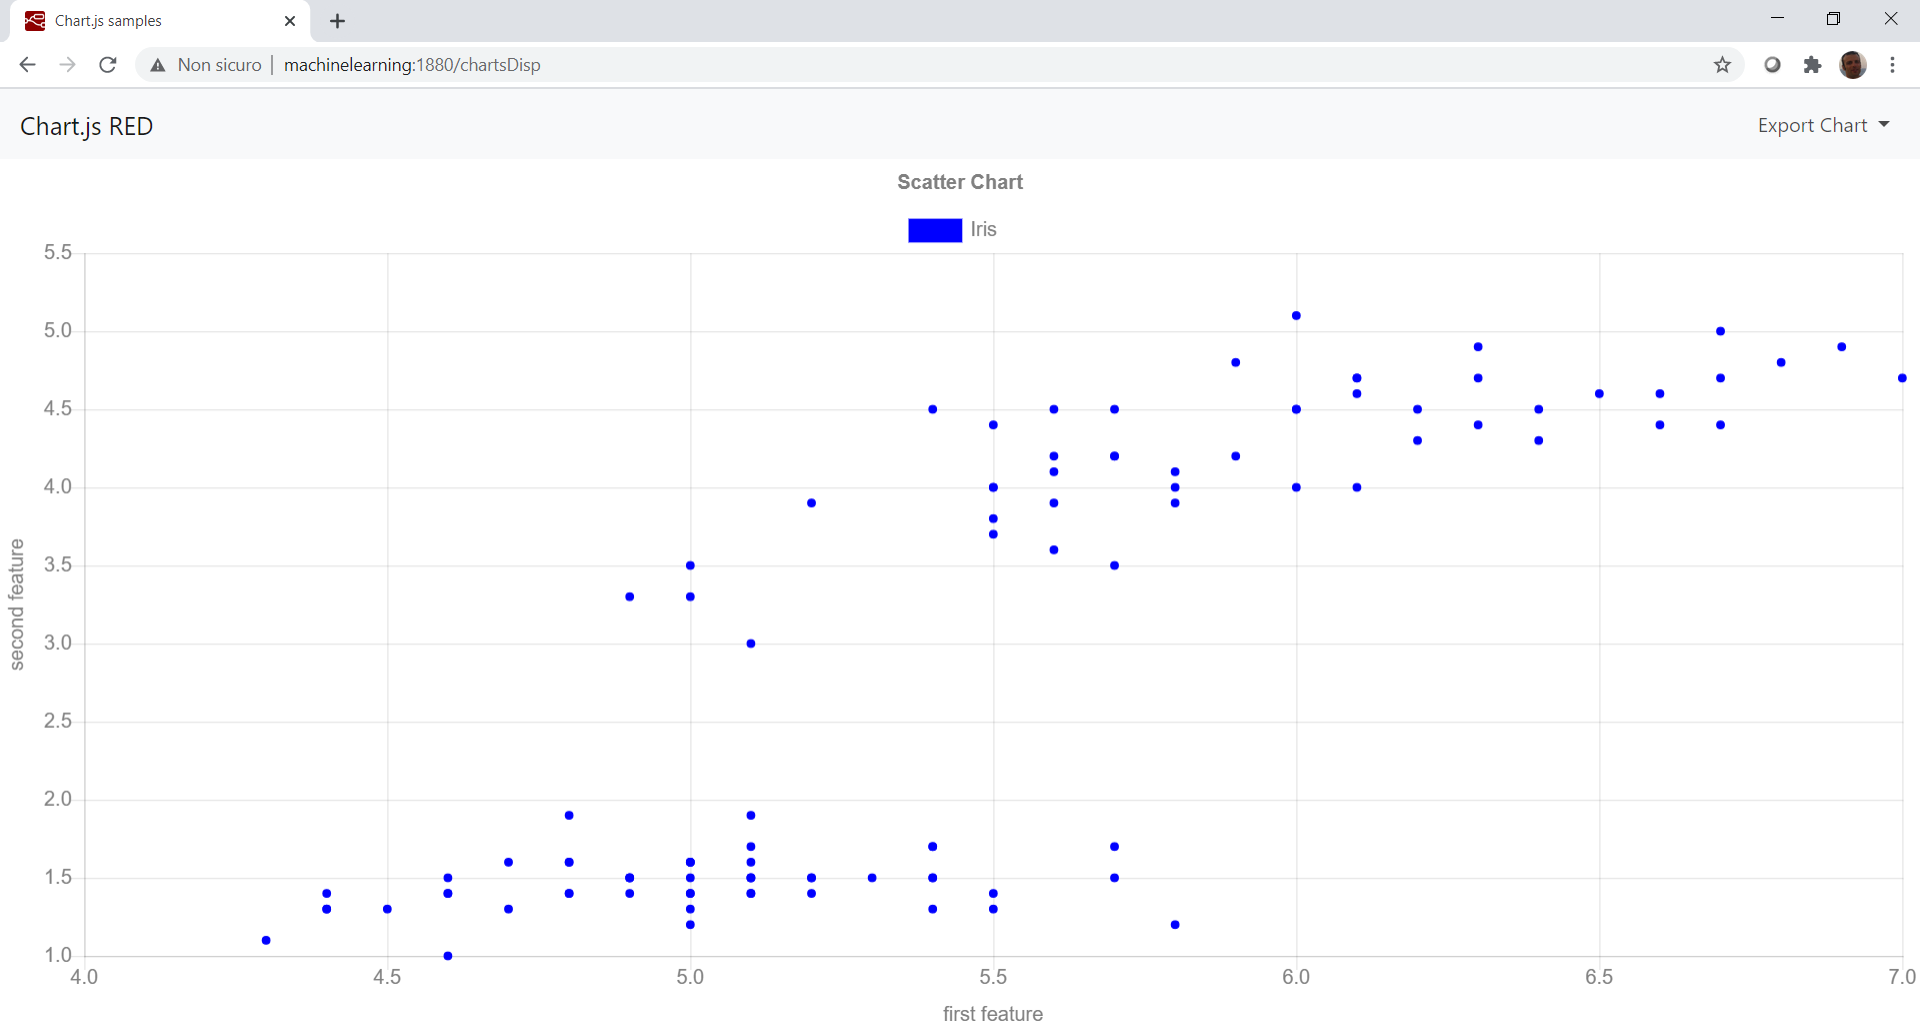
usiamo un grafico a dispersione per visualizzare il dataset inziale:

Come si vede nel grafico abbiamo una netta distinzione della classificazione binaria. La parte alta sono campioni relativi al target -1 mentre la parte bassa sono campioni relativi alla classe 1.

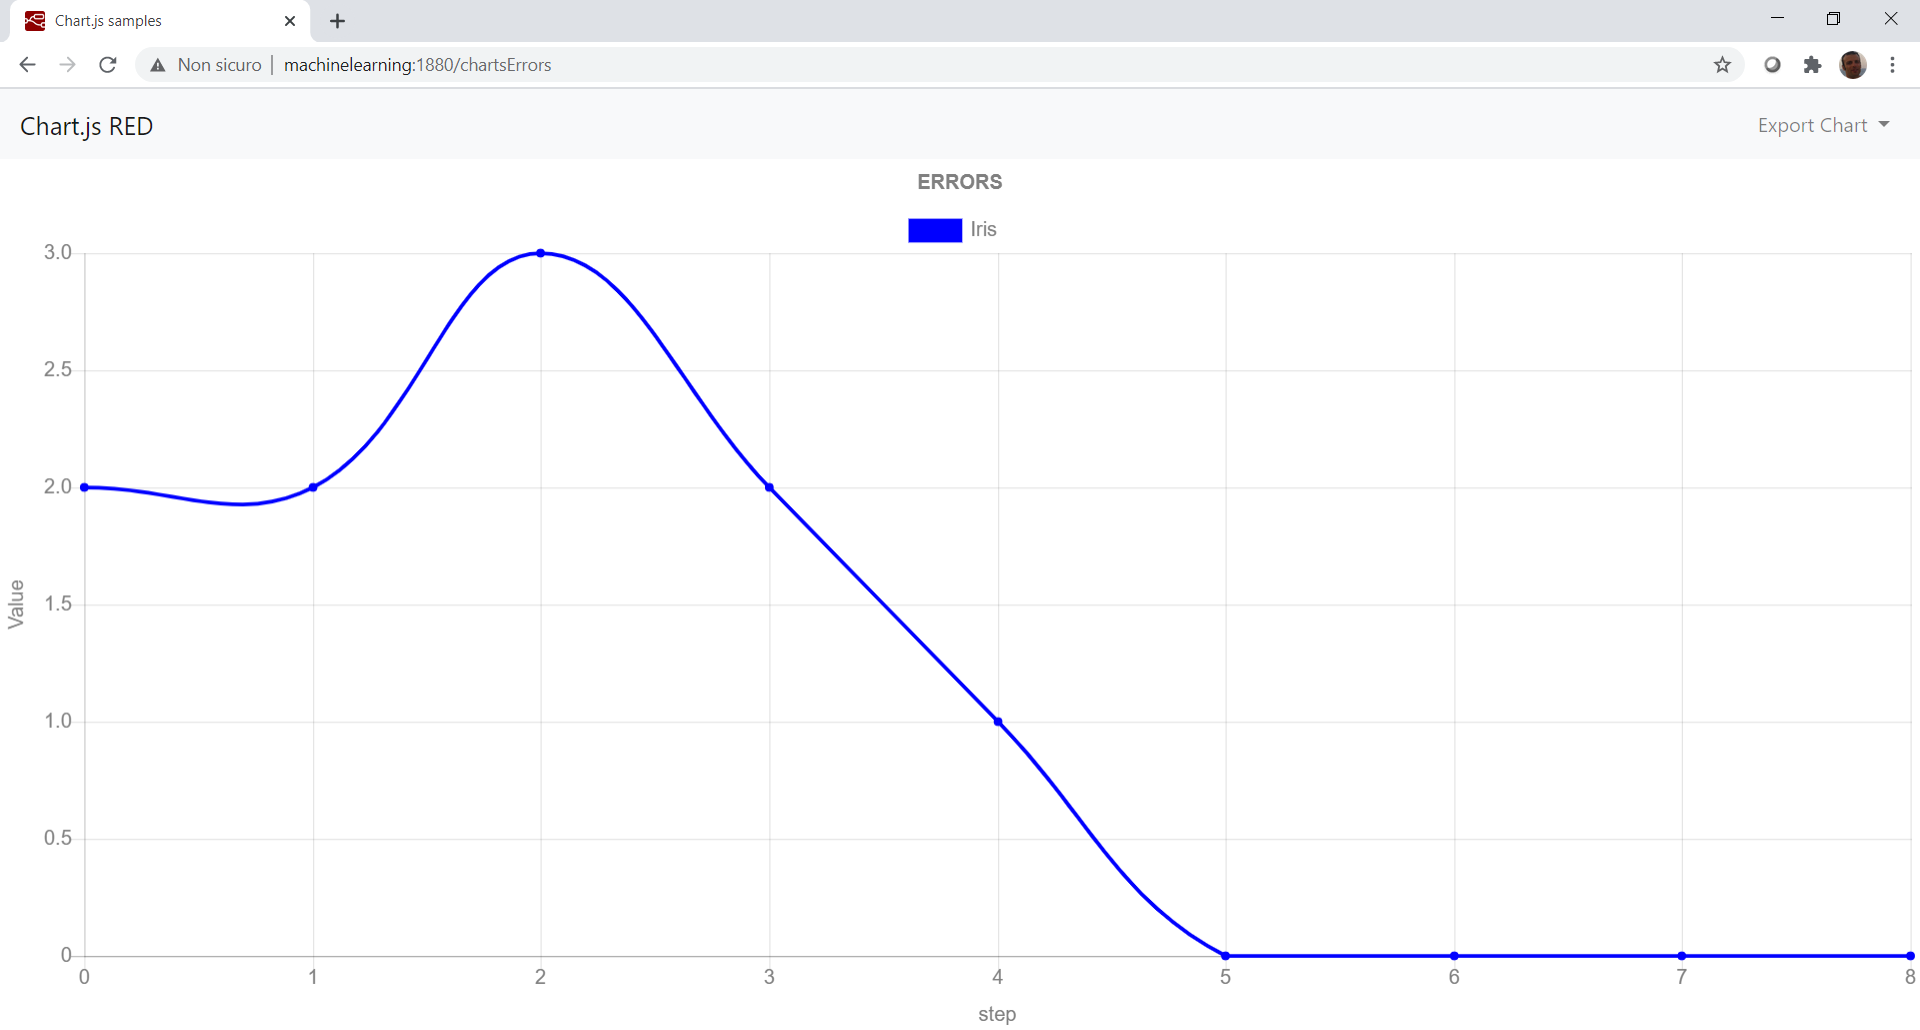
Proviamo ad importare questo dataset in modo da addestrare l’algoritmo. Per capire la precisione di classificazione dell’algoritmo dobbiamo osservare il grafico degli errori ad ogni step di apprendimento. L’algoritmo, inoltre, accetta due parametri in ingresso: il numero di iterazioni (i cicli nei quali si aggiornano i pesi) ed il tasso di apprendimento. Il risultato è il seguente:

Notiamo che dalla quinta iterazione l’errore si azzera, ciò vuol dire che già dalla quinta iterazione l’algoritmo è in grado di predire il risultato per ogni nuovo campione in ingresso.

Proviamo quindi la funzione predict con il campione: Y = np.array([4,1]), ovvero caratteristiche 4 e 1. L’algoritmo ci dovrà predire se sono caratteristiche di Iris-setosa oppure Iris-virginica.

  • print(“predict: ” perceptron.predict(Y))–> predict: -1
  • proviamo con Y = np.array([4,1]), predict: 1

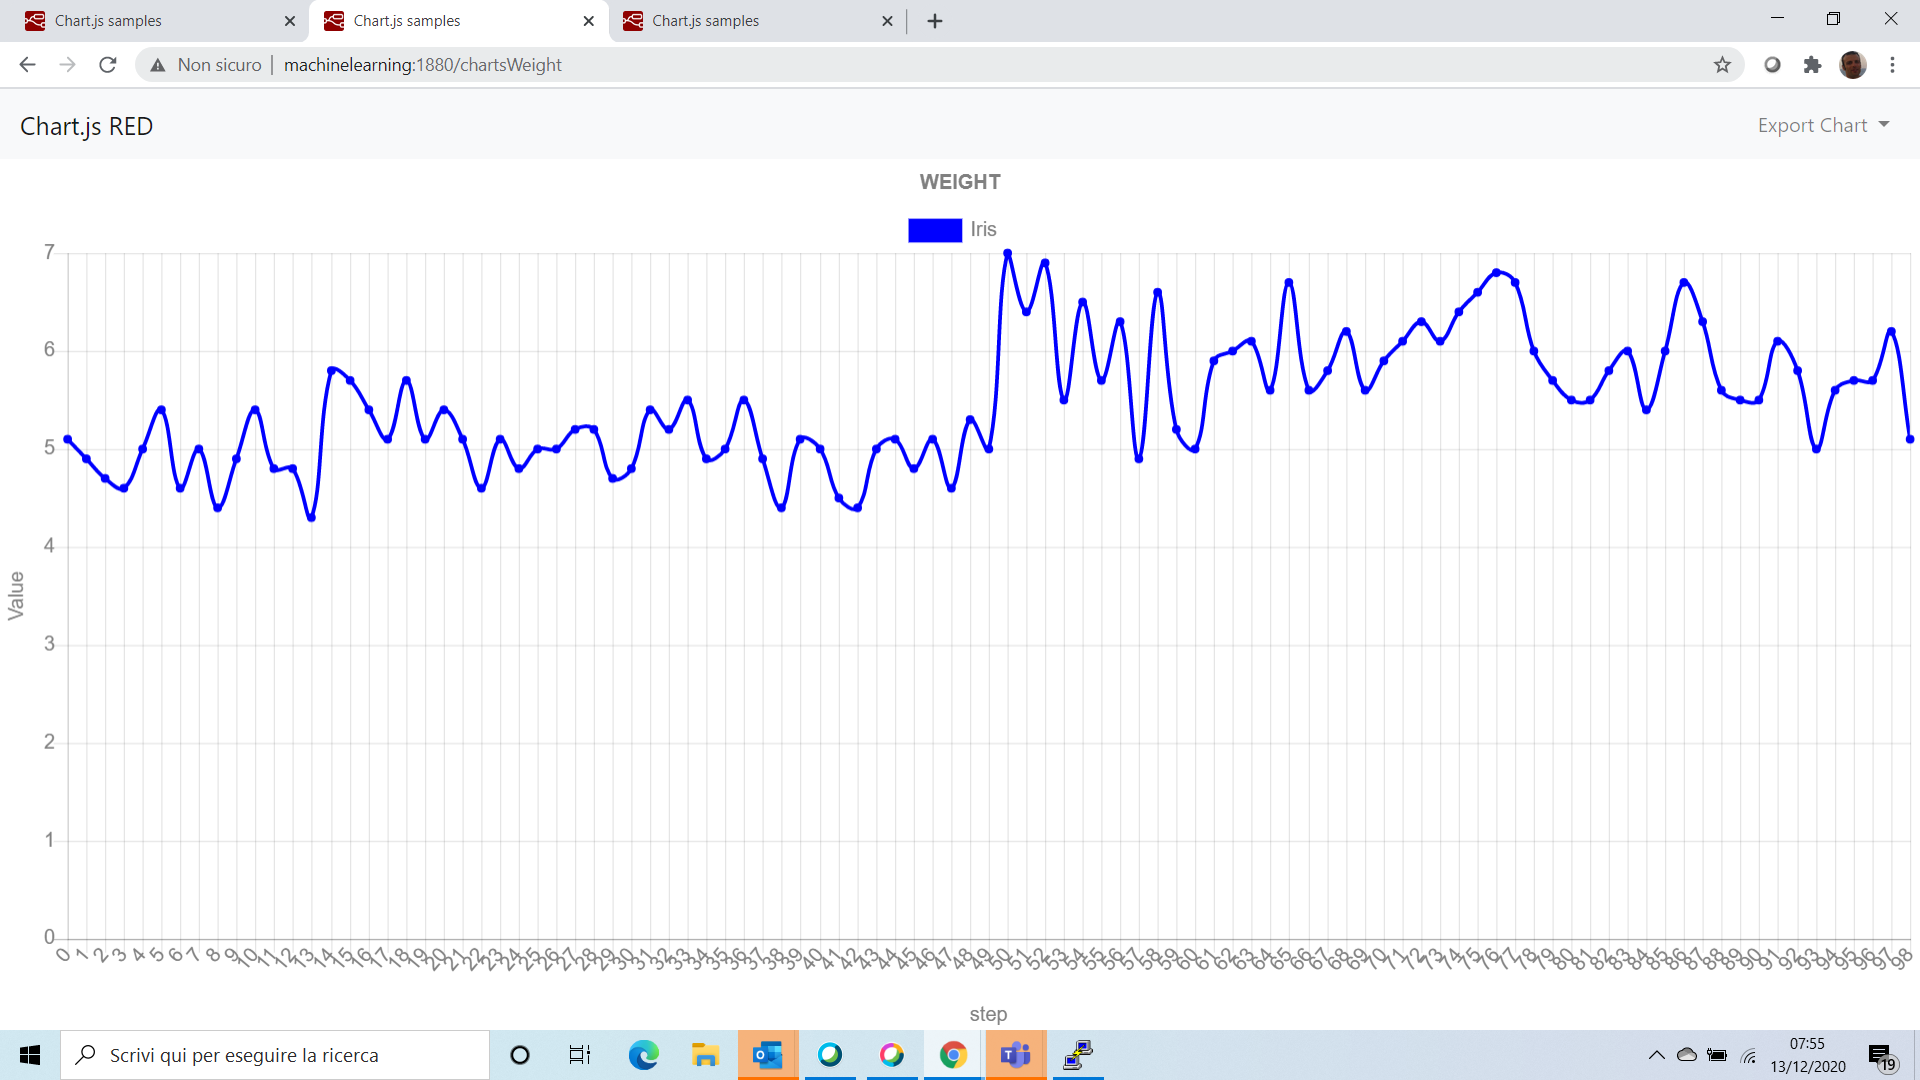
Un altro grafico interessante è l’andamento dei pesi ad ogni iterazione. Con questo grafico visualizziamo passo passo la correzione che l’algoritmo esegue sui pesi per migliorare la predizione.

variazione dei pesi su tutti campioni

PERCEPTRON: come simulare un neurone

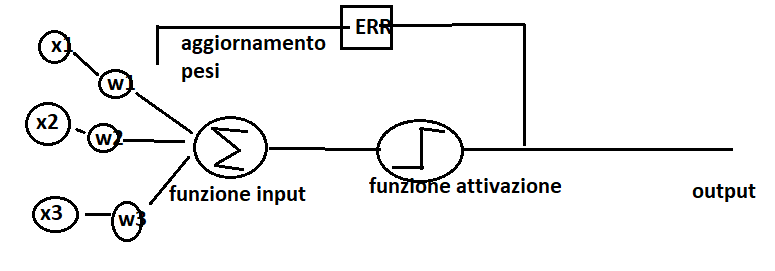
Immaginiamo di modellare un neurone artificiale come un elaboratore che può avere segnali in input e segnali di output. Il segnale entra attraverso i dendriti della cellula ed attraverso l’assone arriva fino ai terminali. Quando il segnale in input supera una determinata soglia allora si attiva il neurone e l’output è positivo. Al contrario l’output rimane negativo.

Il problema descritto sopra può essere rappresentato come un compito di classificazione binaria (+1; -1). I dati in ingresso entrano dentro l’elaboratore, che modelliamo con una funzione di attivazione Θ(z) e dove z è l’input della rete.

La funzione di attivazione che vogliamo utilizzare è a passo unitario, ovvero:

Avendo un serie di campioni che entrano nell’elaboratore (dataset) possiamo descrivere l’input in forma vettoriale:

z=w1 x1 + w2 x2 + w3 x3 + w4 x4 +…+ wm xm

wn-> pesi della funzione

x-> rappresentano le caratteristiche del campione e sono espresse in forma vettoriale

In linea teorica noi dovremmo trovare un algoritmo che dato in ingresso un serie di dati, classifica ogni campione sulla base delle caratteristiche. Il modello che intendiamo analizzare è un classificatore binario, quindi, preso in ingresso una serie di dati, in base alle caratteristiche, produce una classificazione binaria (1, -1).

Una volta “addestrato” il modello per produrre la classificazione binaria allora, ad ogni nuovo campione in ingresso, siamo in grado di predirne la classificazione (1, -1).

La classificazione è il risultato della funzione di attivazione che preso in ingresso l’input della rete si attiva soltanto se superiamo una determinata soglia θ:

Θ(z)=1 if z>=θ

Θ(z)=-1 altrimenti

oppure, in forma più compatta, portando la soglia alla sinistra dell’equazione:

Θ(z)=1 if z>=θ –> z-θ>=0

z-θ=w1 x1 + w2 x2 + w3 x3 + w4 x4 +…+ wm xm -> z= θ + w1 x1 + w2 x2 + w3 x3 + w4 x4 +…+ wm xm

L’ algoritmo perceptron che emula il neurone si comporterà come segue:

  1. inizializzazione dei pesi a 0 o numeri casuali piccoli
  2. calcolo del valore output y–: etichetta della classe prevista
  3. aggiornamento dei pesi: wj = wj + Δwj, dove Δwj=η(y(i) – y-(i))x(i)j

Dalle formule è evidente che se una predizione risulta errata allora l’aggiornamento del peso avviene in modo proporzionale nella direzione della classe target corretta.

Ad esempio, se abbiamo un campione x(i)j = 2 e l’abbiamo predetto nella classe errata y-(i)= -1 ed il tasso di apprendimento η=1, allora, l’aggiornamento del peso risulta essere:

Δwj=η(y(i) – y-(i))x(i)j = Δwj=1(1 – -1)2 = 4, l’algoritmo aggiorna i pesi in maniera proporzionale verso la classe corretta.

In conclusione, il perceptron, è un algoritmo di classificazione binaria in grado di predire una determinata classe attraverso le caratteristiche del campione.

Machine Learning in teoria

apprendimento con supervisione

classificazione, esempio messaggi di spam (classificazione binaria) oppure la classificazione multiclasse (riconoscimento testo scritto a mano)

regressione, trovare la dipendenza tra variabili predittive discrete ed una variabile target continua

apprendimento di rafforzamento

agente che migliora le prestazioni grazie all’interazione con l’ambiente. Siccome nelle informazioni relative all’ambiente includono anche un segnale di ricompensa, allora, si può dire che l’apprendimento di rafforzamento è l’esempio di un apprendimento con supervisione. Il target non è l’etichetta ma la “ricompensa” che misura la qualità con cui la funzione è stata misurata. Esempio, motore del gioco scacchi. Con try-and-error per migliorare la qualità dell’apprendimento

apprendimento senza supervisione

dati non etichettati o dati dalla struttura ignota. Necessario osservare i dati per cercare di capire informazioni cariche di significato.

clustering: dati divisi su un determinato grado di similarità (popolazione delle malattie), marketing per classificare gruppi di clienti

compressione dati (riduzione dimensionale): si esegue nella preelaborazione dei dati per cercare di ridurre il numero di dimensioni e ridurre il carico di memoria usata. si usa la matrice e vettori. Ogni colonna della matrice rappresenta la caratteristica del campione.

Quali sono in generale gli step per la creazione di sistemi di apprendimento automatico?

PRE-ELABORAZIONE

questo step serve per dare una forma ai dati. Cercare di rendere le caratteristiche dei dati omogenei (grazie anche alle attività di normalizzazione), cancellazione delle ridondanze andando a verificare la correlazione delle caratteristiche. Riduzione della dimensionalità delle caratteristiche riducendo quindi anche le prestazioni computazionali

ADDESTRAMENTO E SELEZIONE DI UN MODELLO PREDITTIVO

In questo step si cerca il miglior modello predittivo per un determinato problema. Per trovare il modello migliore si utilizzano delle metriche per misurare le prestazioni di ciascun modello. Per l’addestramento del modello si utilizza un dataset di apprendimento mentre per la valutazione del modello si utilizza un dataset di test.

VALUTAZIONE DEI MODELLI E PREVISIONI

In questo step si utilizza il dataset di test per stimare la qualità del modello predittivo e per identificare l’errore di generalizzazione. Se, dall’analisi, siamo soddisfatti della prestazione allora possiamo utilizzare il modello scelto per predire nuovi dati.

VideoTutorial 1: Dall’ordine d’acquisto all’entrata merci

Il primo videotutorial mostra come iniziare da subito a creare un ordine di acquisto per comprare merce e per immagazzinarla in magazzino.

La merce entrerà attraverso un attributo di istanza (lotto) in modo da poter riconoscere univocamente il prodotto.

La nostra azienda si chiama infogest e commercializza semi per piante.

Nel tutorial compreremo 1000 semi di zucca e faremo l’entrata merce specificando l’identificativo del lotto.

Progetto ERP in azienda, alcune considerazioni ed errori comuni

Con questo articolo vorrei condividere alcune considerazioni, maturate dopo anni di esperienza in sistemi di gestione ERP (prendendo anche spunto dalle discussioni nate su informaticagestionale.it), su quali possono essere gli errori più comuni e quali i possibili rimedi per un progetto ERP aziendale.

In seguito una lista che, dal mio punto di vista, rappresentano gli errori più frequenti in un progetto di migrazione ERP.

  1. Evitare di identificare un applicativo ERP soltanto come un software gestionale contabile qualsiasi; molte volte si pensa che il gestionale aziendale ERP riguardi soltanto la sfera contabile ed amministrativa (ciclo attivo, ciclo passivo, registrazione prime note, piano dei conti…). La gestione della contabilità è una delle funzioni di un gestionale ERP ma non è l’unica. Con questo errore si rischia di “isolare” l’applicativo per i soli scopi contabili e non si sfrutta per le reali potenzialità di integrazione e di supporto trasversale dell’operatività aziendale. Inoltre, a lungo andare, si rischia di rendere l’intero ecosistema informatico altamente improduttivo: se ERP è usato solo in un settore aziendale vuol dire che probabilmente serviranno altri software per la gestione di altri settori aziendali aumentando così i costi di manutenzione e di integrazione dell’intera infrastruttura.
  2. Evitare di scegliere il software ed il partner prima di eseguire l’analisi e l’ottimizzazione dei processi. Con questo errore, quasi certamente, ci si ritrova a dover adattare i processi aziendali al software ERP. In realtà dovrebbe essere fatto esattamente il contrario. Prima di tutto si analizza il contesto, si esegue un’analisi adeguata, si standardizzano i processi e, soltanto dopo, si cerca il software più adatto a gestire il nuovo contesto aziendale. Può succedere che, dopo un’attenta analisi, adottare un sistema ERP non è poi così vantaggioso.
  3. Altro errore è non adottare una metodologia di customizzazione e sviluppo in stretta collaborazione con il proprio partner già esplicitato sul contratto di collaborazione. Un progetto ERP deve essere analizzato ed adattato già dalle prime fasi di customizzazione e deve essere supportato da un contratto che assicuri una piena flessibilità di implementazione. Con questa metodologia, il cliente può valutare attraverso continui feedback (esattamente come nell’approccio AGILE) se, durante le fasi di implementazione, si stanno rispettando i requisiti richiesti.
  4. Evitare di sottovalutare un progetto ERP: un progetto ERP, per ottenere i massimi vantaggi, è per sua natura complesso. Viene coninvolta una buona parte dell’organizzazione: processi operativi e decisionali, personale, ruoli, mansioni, funzioni ecc. Inoltre coinvolge anche altre tematiche come: la trasformazione digitale, il supporto del passaggio dell’informazione in maniera trasversale tra i vari reparti aziendali, riorganizzazione interna dei processi, impegno economico non indifferente ecc. Un progetto ERP ha un ciclo di vita decennale e deve quindi essere una scelta strategica.
  5. Evitare di creare funzionalità (o plugin) adhoc laddove non esiste una forte necessità. Anche se ormai una buona parte dei gestionali permettono di sviluppare plugin aggiuntivi, lo sviluppo di funzionalità “esterne” deve essere una scelta ponderata su questi elementi:
    1. ogni funzionalità “esterna” deve essere ben integrata con il sistema stesso. Ad esempio, se facessi creare una funzionalità esterna che prevede la “messa a macero” delle merci in magazzino devo anche assicurarmi che tale operazione vada ad incidere sulla valorizzazione contabile del magazzino e non soltanto sulle quantità fisiche eliminate. Sembra banale dirlo ma, a livello di implementazione, non è così semplice integrare funzionalità “esterne” con un gestionale ERP. In molti casi le applicazioni ERP definiscono alcune linee guida per lo sviluppo di plugin esterni; bisogna solo assicurarsi che chi sviluppa utilizzi gli stessi criteri.
    2. Assicurarsi che non esista già un plugin pensato per fare la stessa cosa. Ogni nuovo sviluppo di applicazioni esterne deve seguire la fase di specifiche, implementazione, test e deploy. Se la funzionalità fosse già stata sviluppata allora il risparmio di tempo e costi è notevole.
    3. Più un plugin è pervasivo, cioè che si interpone in profondità negli ingranaggi dell’ERP (creazione fatture, movimentazione merci, acquisti, vendite…), più il partner al quale si affida lo sviluppo dovrà essere affidabile. In questo modo si evita che una funzionalità che è diventata parte integrante del sistema ERP (per il proprio contesto aziendale) non venga più adeguatamente supportata nel lungo periodo (uno dei maggiori motivi può essere la cessazione o cambio attività del partner). Il rischio è di vincolare la manutenzione del software generico (magari gestito a livello mondiale) alle sorti di un partner che ha sviluppato un’estensione (magari su vostra richiesta) in maniera pervasiva.